
Capacités des modèles
Comparez les modèles selon huit dimensions, de l’intelligence au coût d’utilisation et à la réactivité.
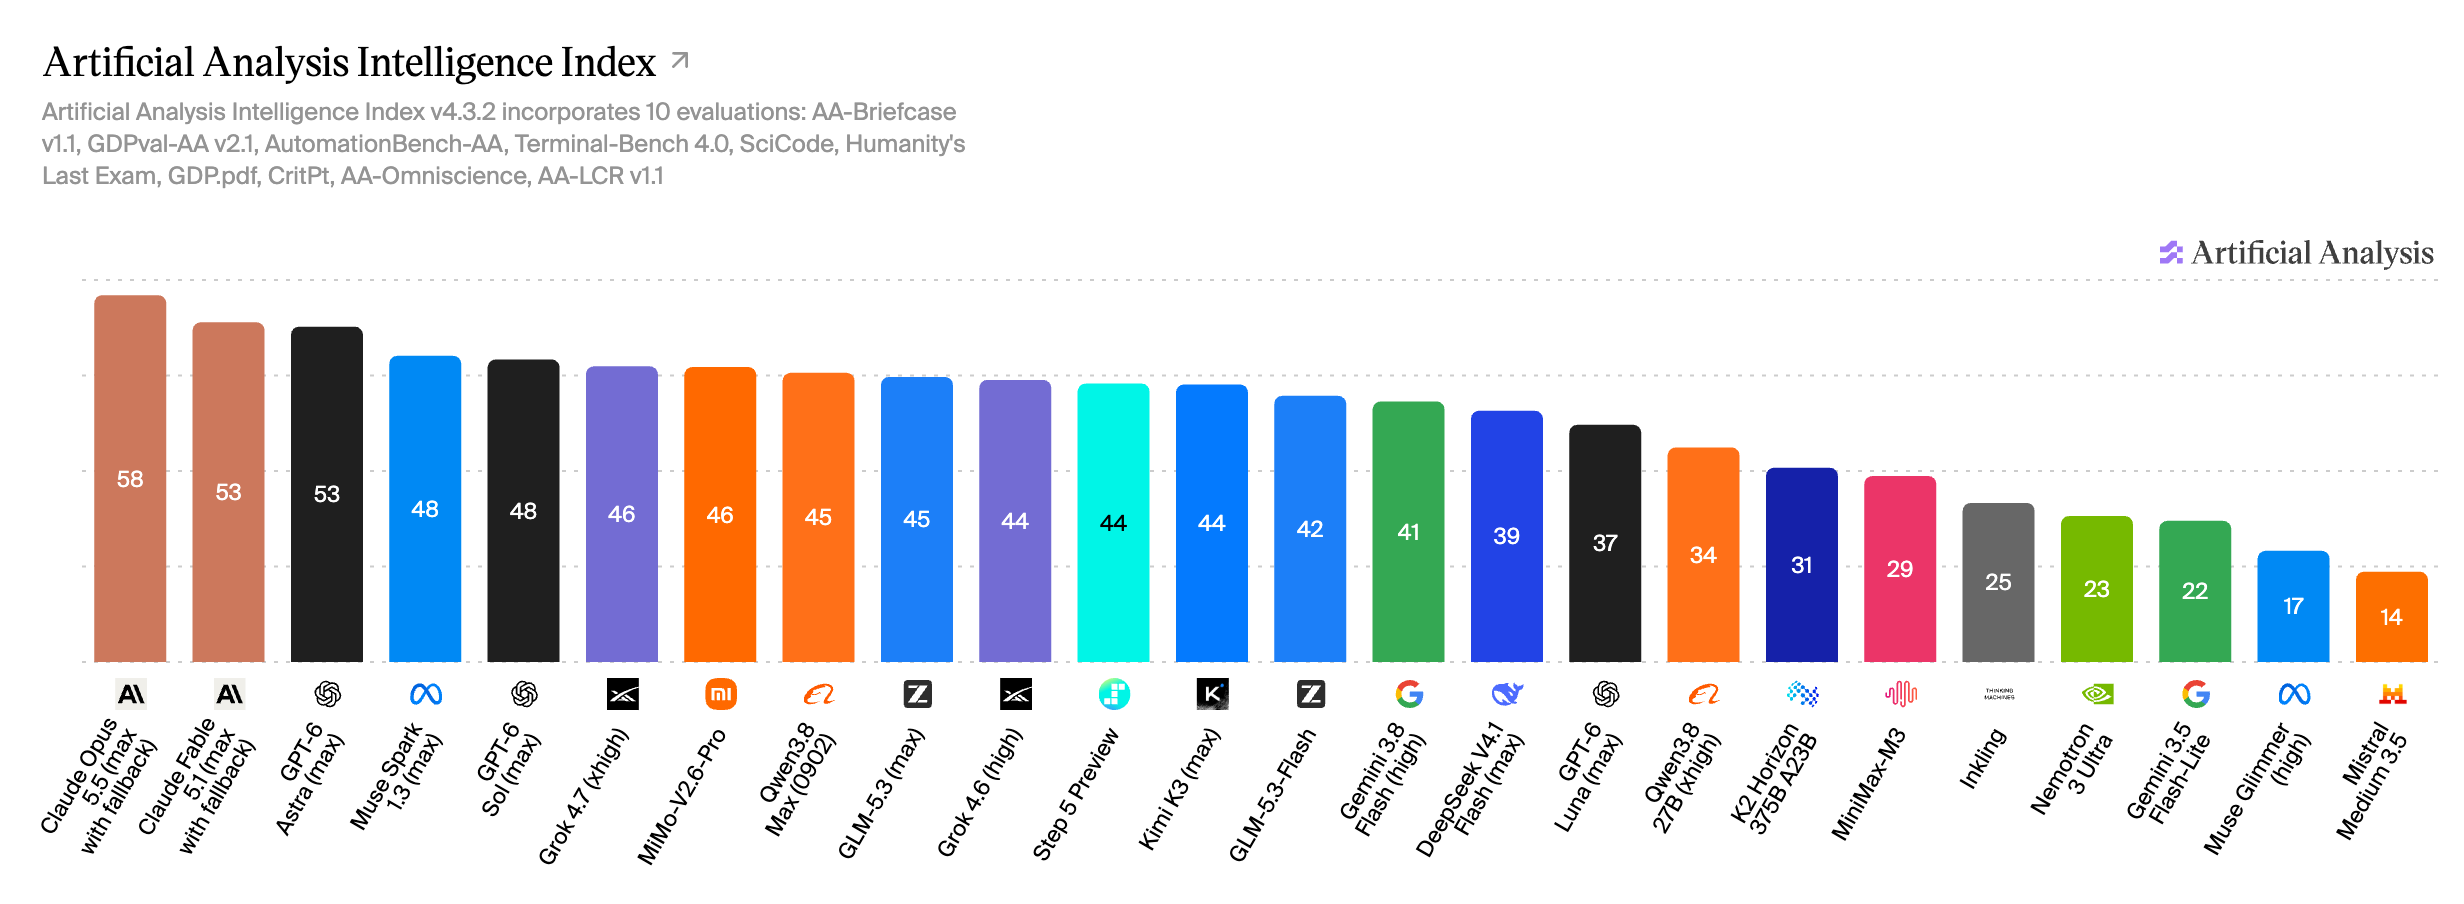
Intelligence globale
Comparez les capacités globales en raisonnement, programmation et travail intellectuel.
Lecture du graphique
Dans cette sélection, Opus 5.5 mène à 58 ; Fable 5.1 et GPT-6 Astra sont arrondis à 53. Les réglages de raisonnement font partie du résultat.
Évaluations spécialisées
Examinez séparément programmation, raisonnement, connaissances factuelles, contexte long et raisonnement visuel.
Explorer les 19 graphiques d’évaluation19 évaluations · échelles distinctes
Lecture du graphique
Les leaders varient selon la tâche : Terminal-Bench et SciCode pour le code, AA-LCR pour le raisonnement en contexte long, MMMU-Pro pour le visuel.
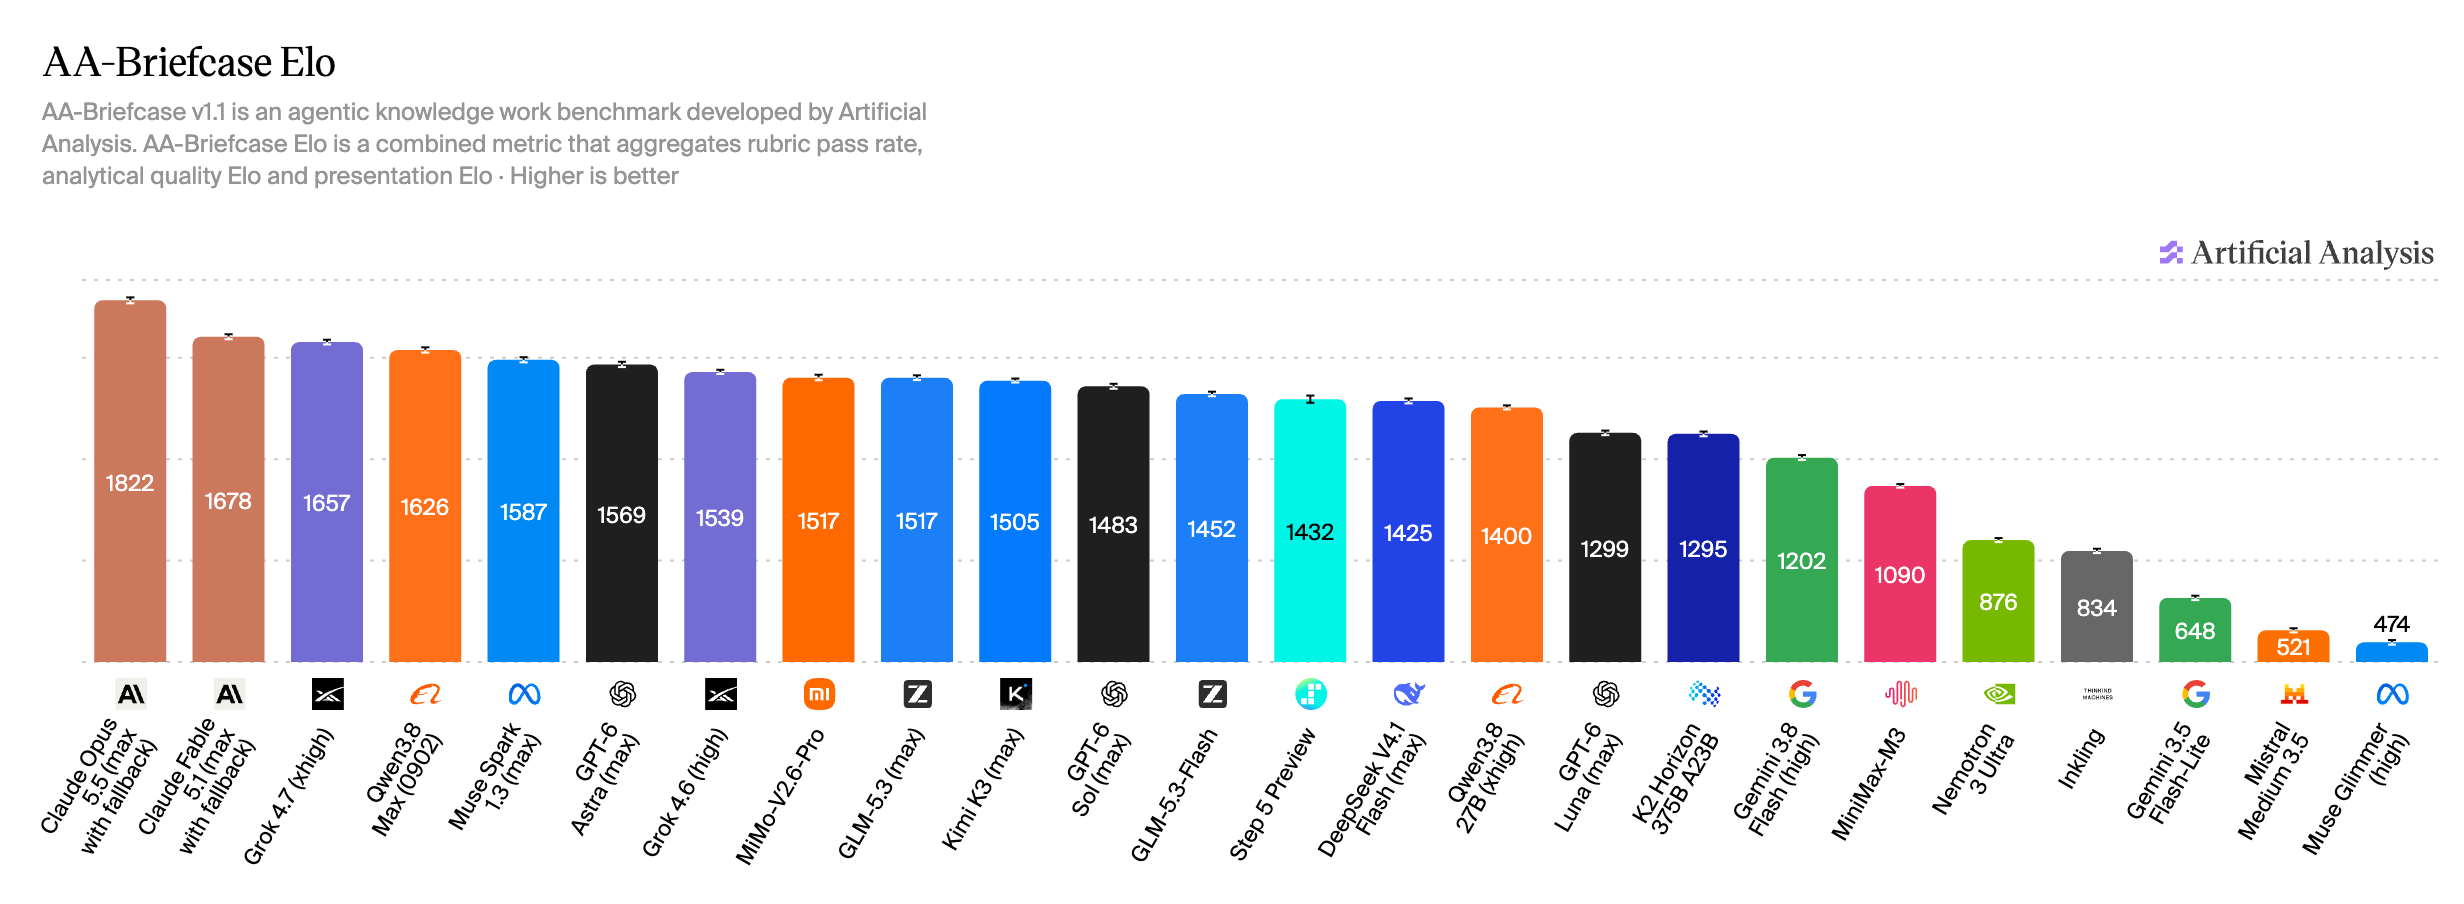
Agents de travail intellectuel
Évaluez si un agent peut transformer une demande complexe en livrable utile.
Lecture du graphique
Dans cette sélection, Opus 5.5 atteint 1822 Elo, suivi de Fable 5.1 à 1678 et de Grok 4.7 à 1657.
Intelligence et coût
Trouvez les capacités nécessaires à un coût par tâche soutenable.

Lecture du graphique
La zone supérieure gauche associe capacité élevée et faible coût. La frontière en pointillés aide à repérer les choix efficaces dans la sélection.
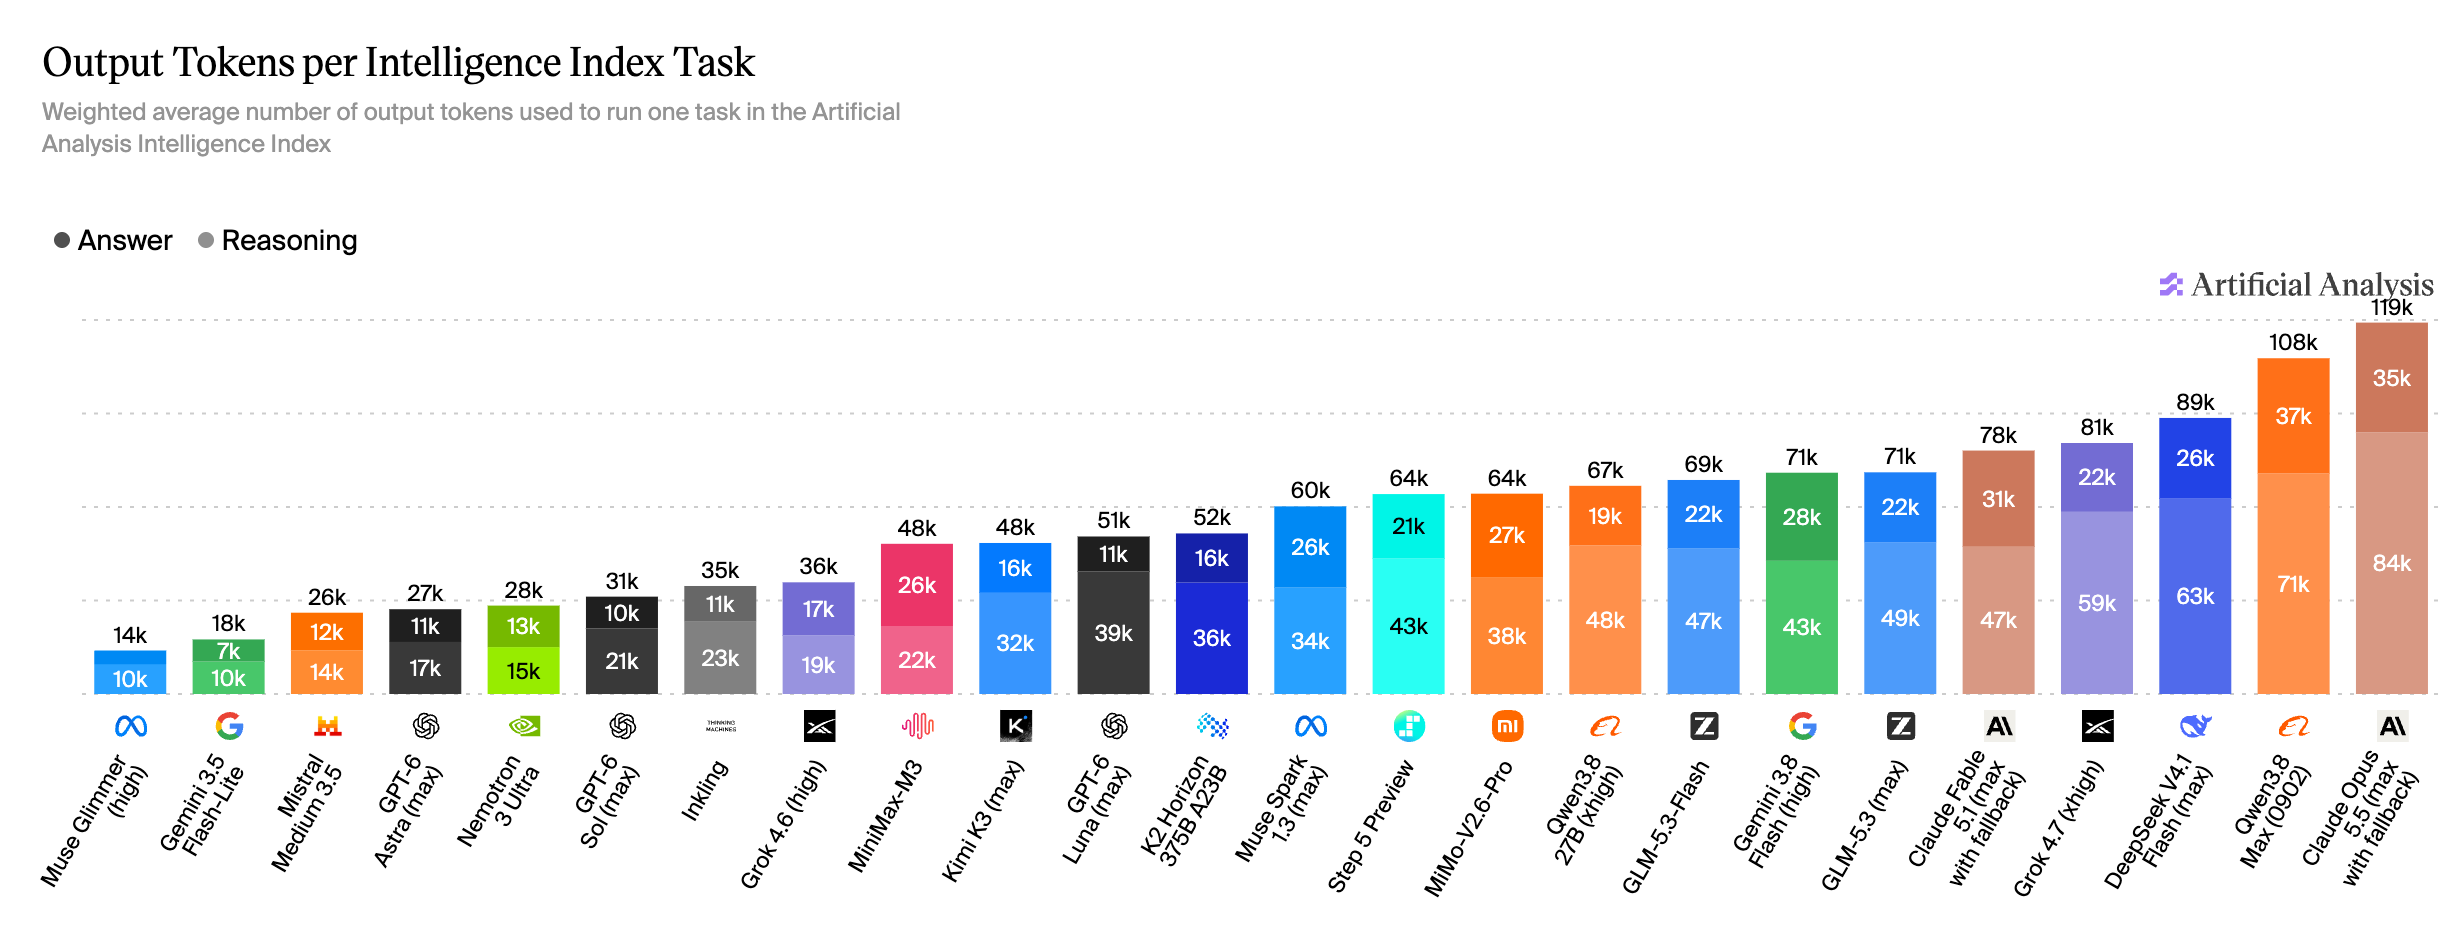
Efficacité en tokens
Observez les tokens de raisonnement et de réponse consommés par tâche d’évaluation.
Lecture du graphique
Opus 5.5 utilise environ 119k tokens de sortie par tâche, contre 31k pour GPT-6 Sol. Le raisonnement représente une part importante de l’usage.
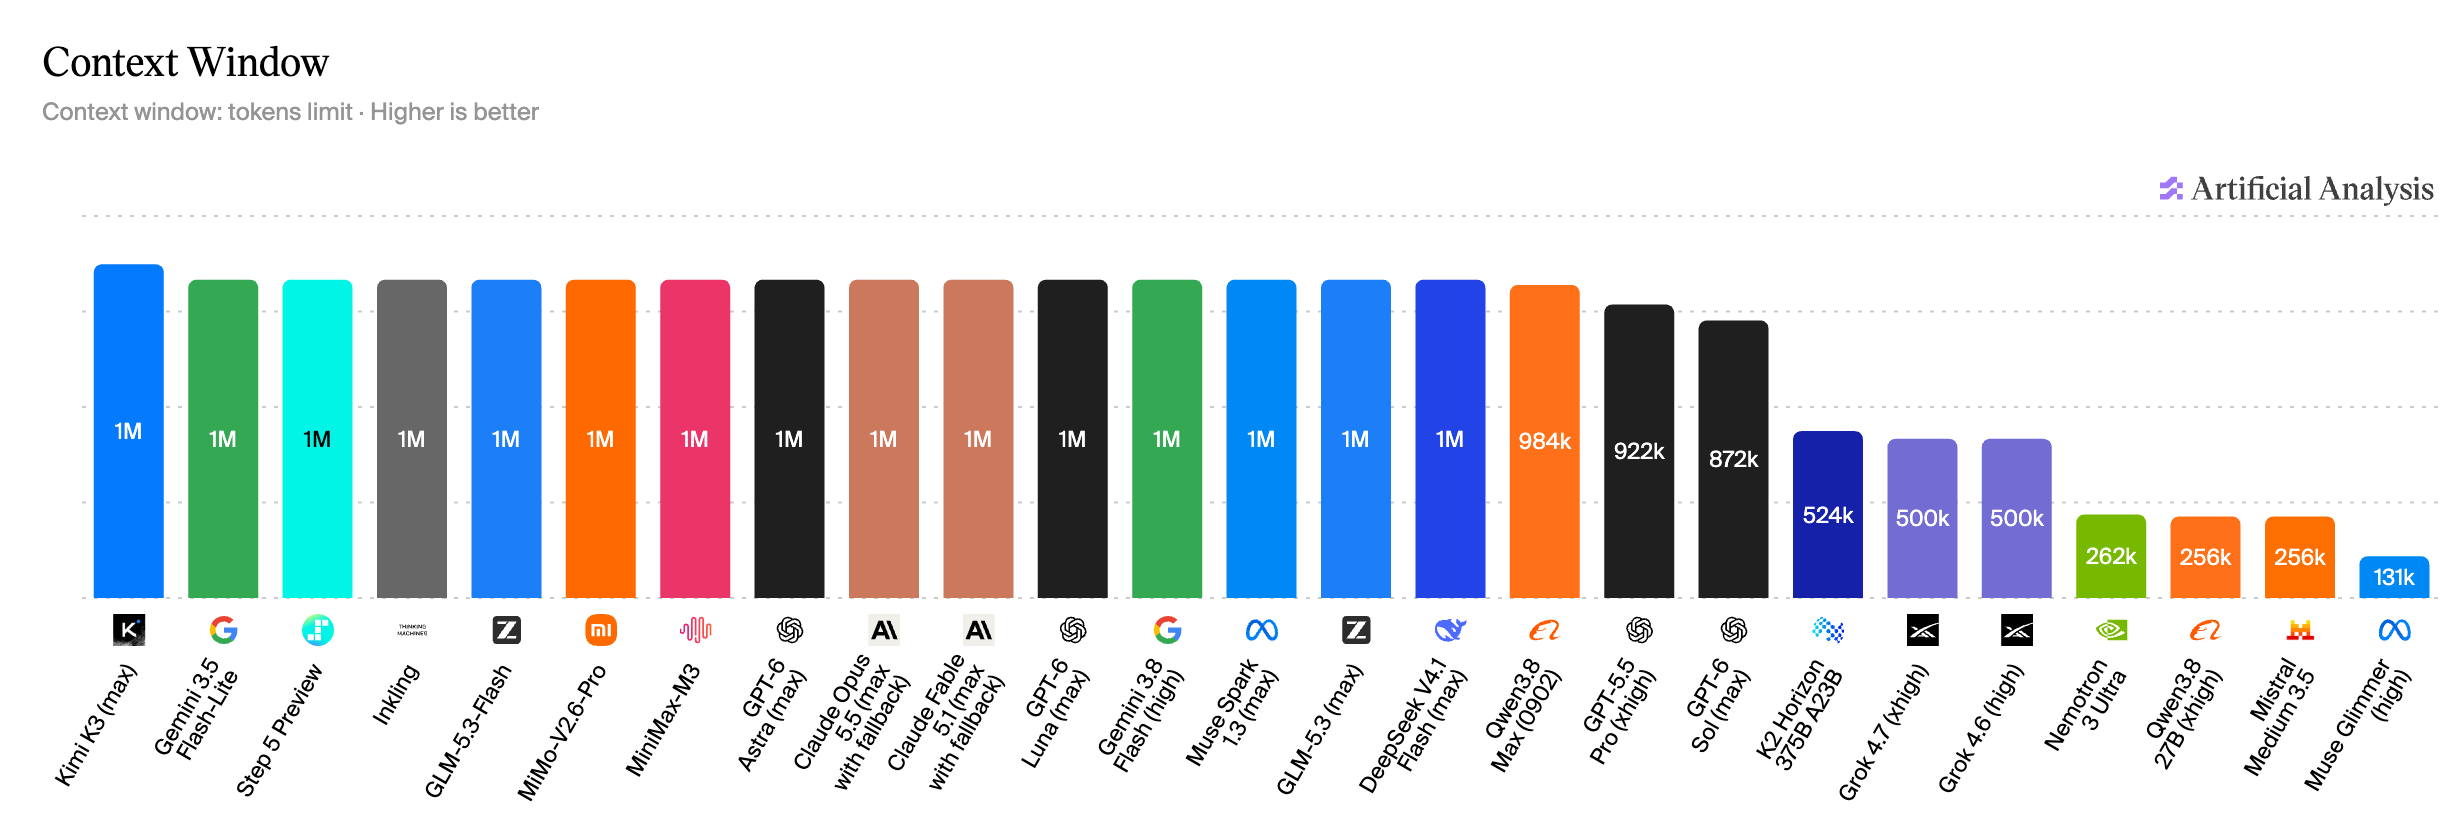
Capacité du contexte
Comparez l’espace disponible pour les documents, le code et l’historique de conversation.
Lecture du graphique
De nombreux modèles de la sélection offrent environ 1M tokens de contexte ; Grok 4.7 affiche 500k et Mistral Medium 3.5, 256k.
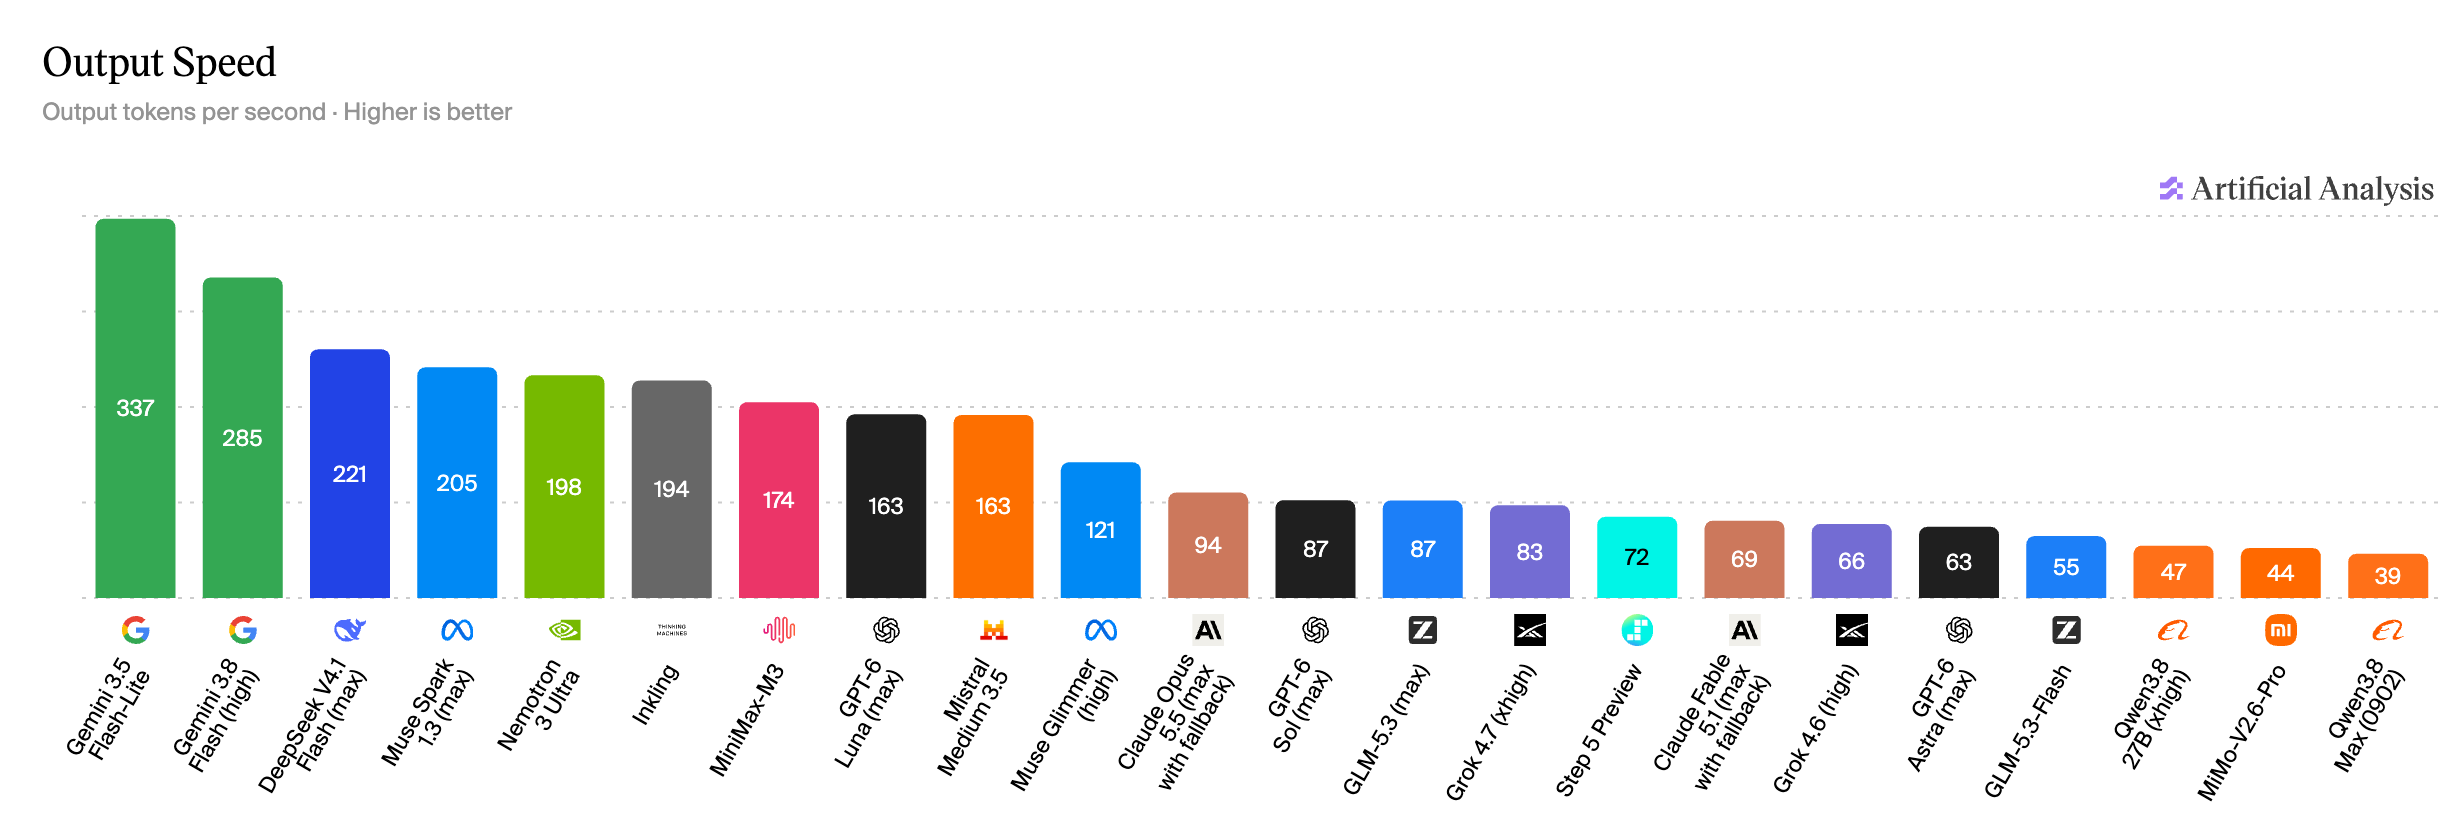
Vitesse de génération
Comparez la vitesse d’arrivée du texte une fois la génération commencée.
Lecture du graphique
Dans cette sélection, Gemini 3.5 Flash-Lite atteint 337 tokens/s et Gemini 3.8 Flash en effort high, 285 tokens/s. Une sortie rapide facilite les réponses longues.
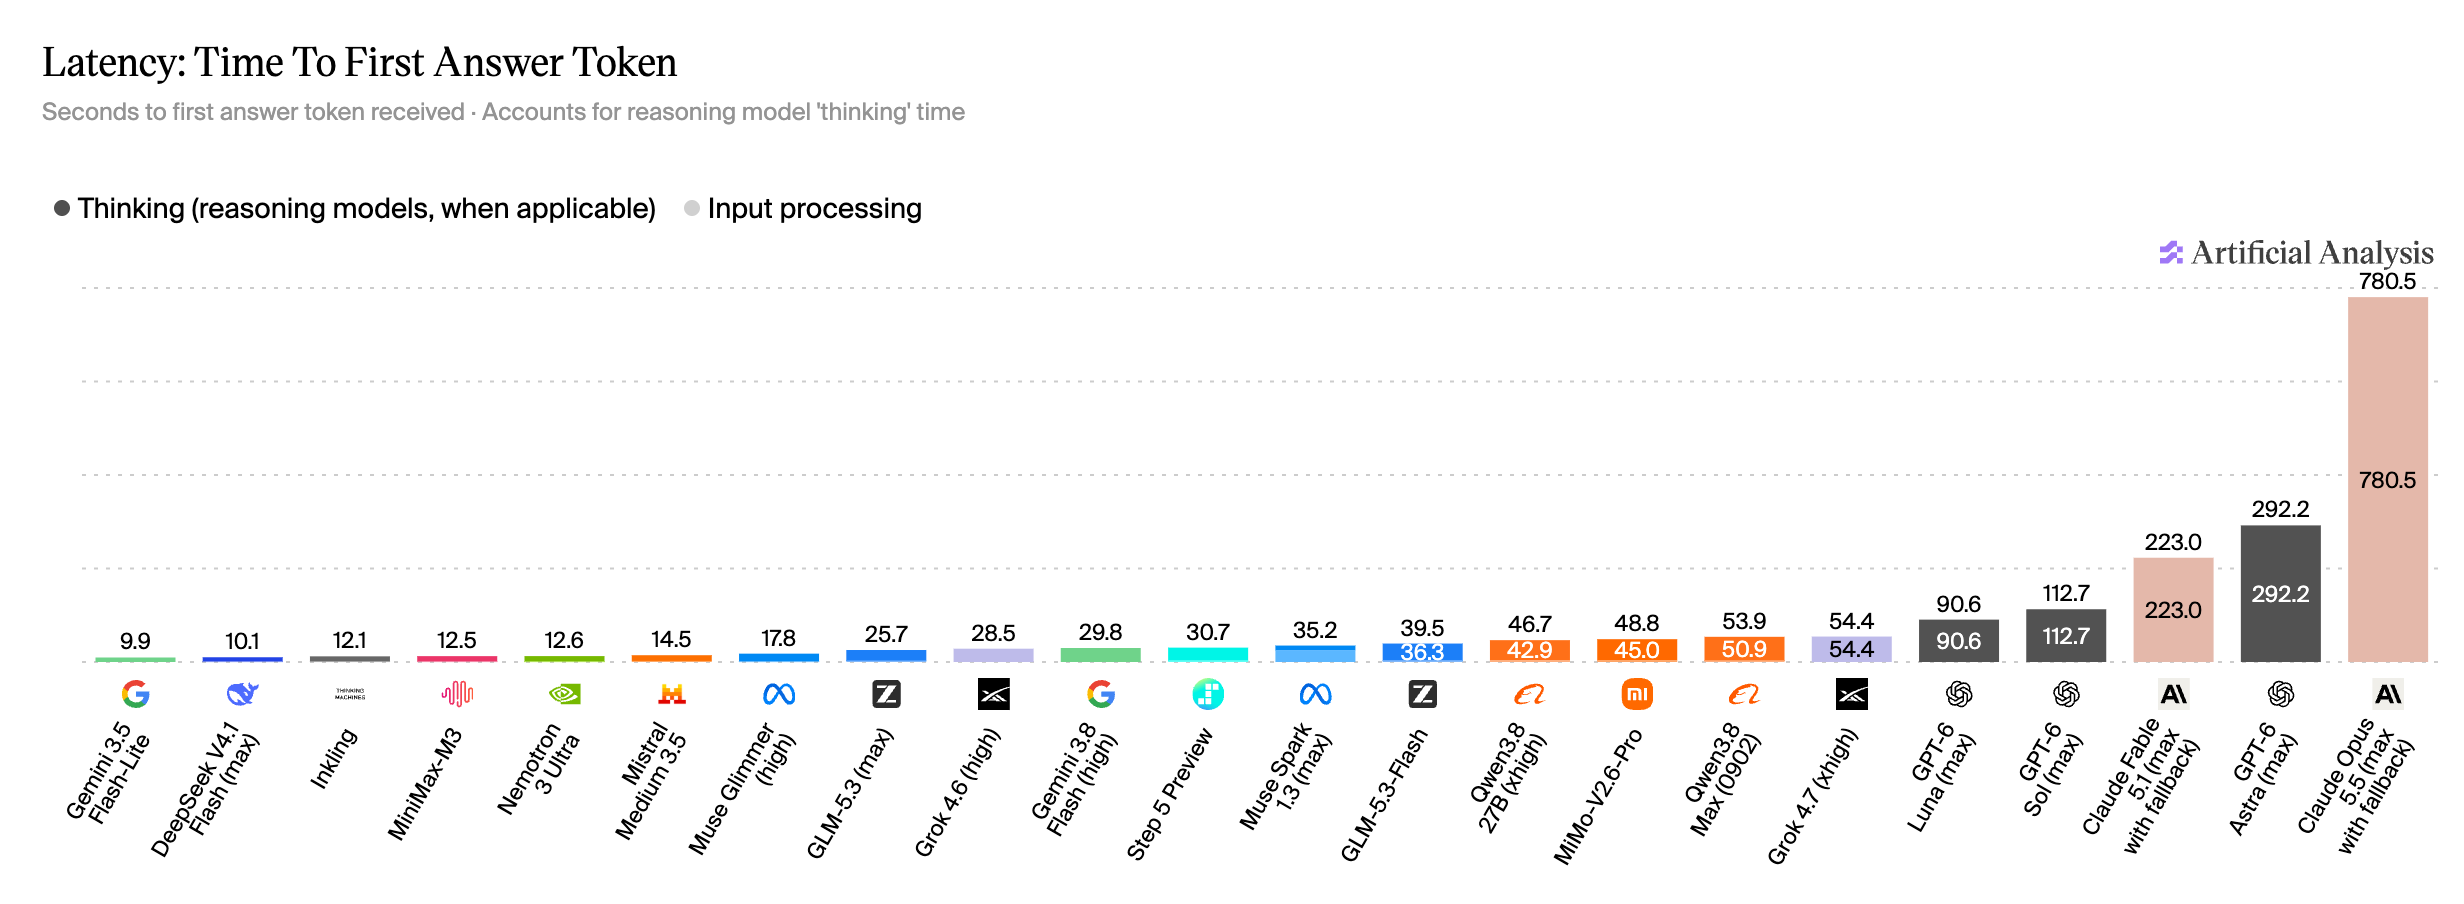
Délai avant la première réponse
Mesurez l’attente avant le premier token de réponse reçu par l’utilisateur.
Lecture du graphique
Grok 4.7 en effort xhigh affiche 54,4 s, contre 292,2 s pour GPT-6 Astra en effort max. Le temps de réflexion peut dominer l’attente perçue.