
Возможности моделей
Сравните модели по восьми измерениям: от интеллекта до стоимости использования и скорости отклика.
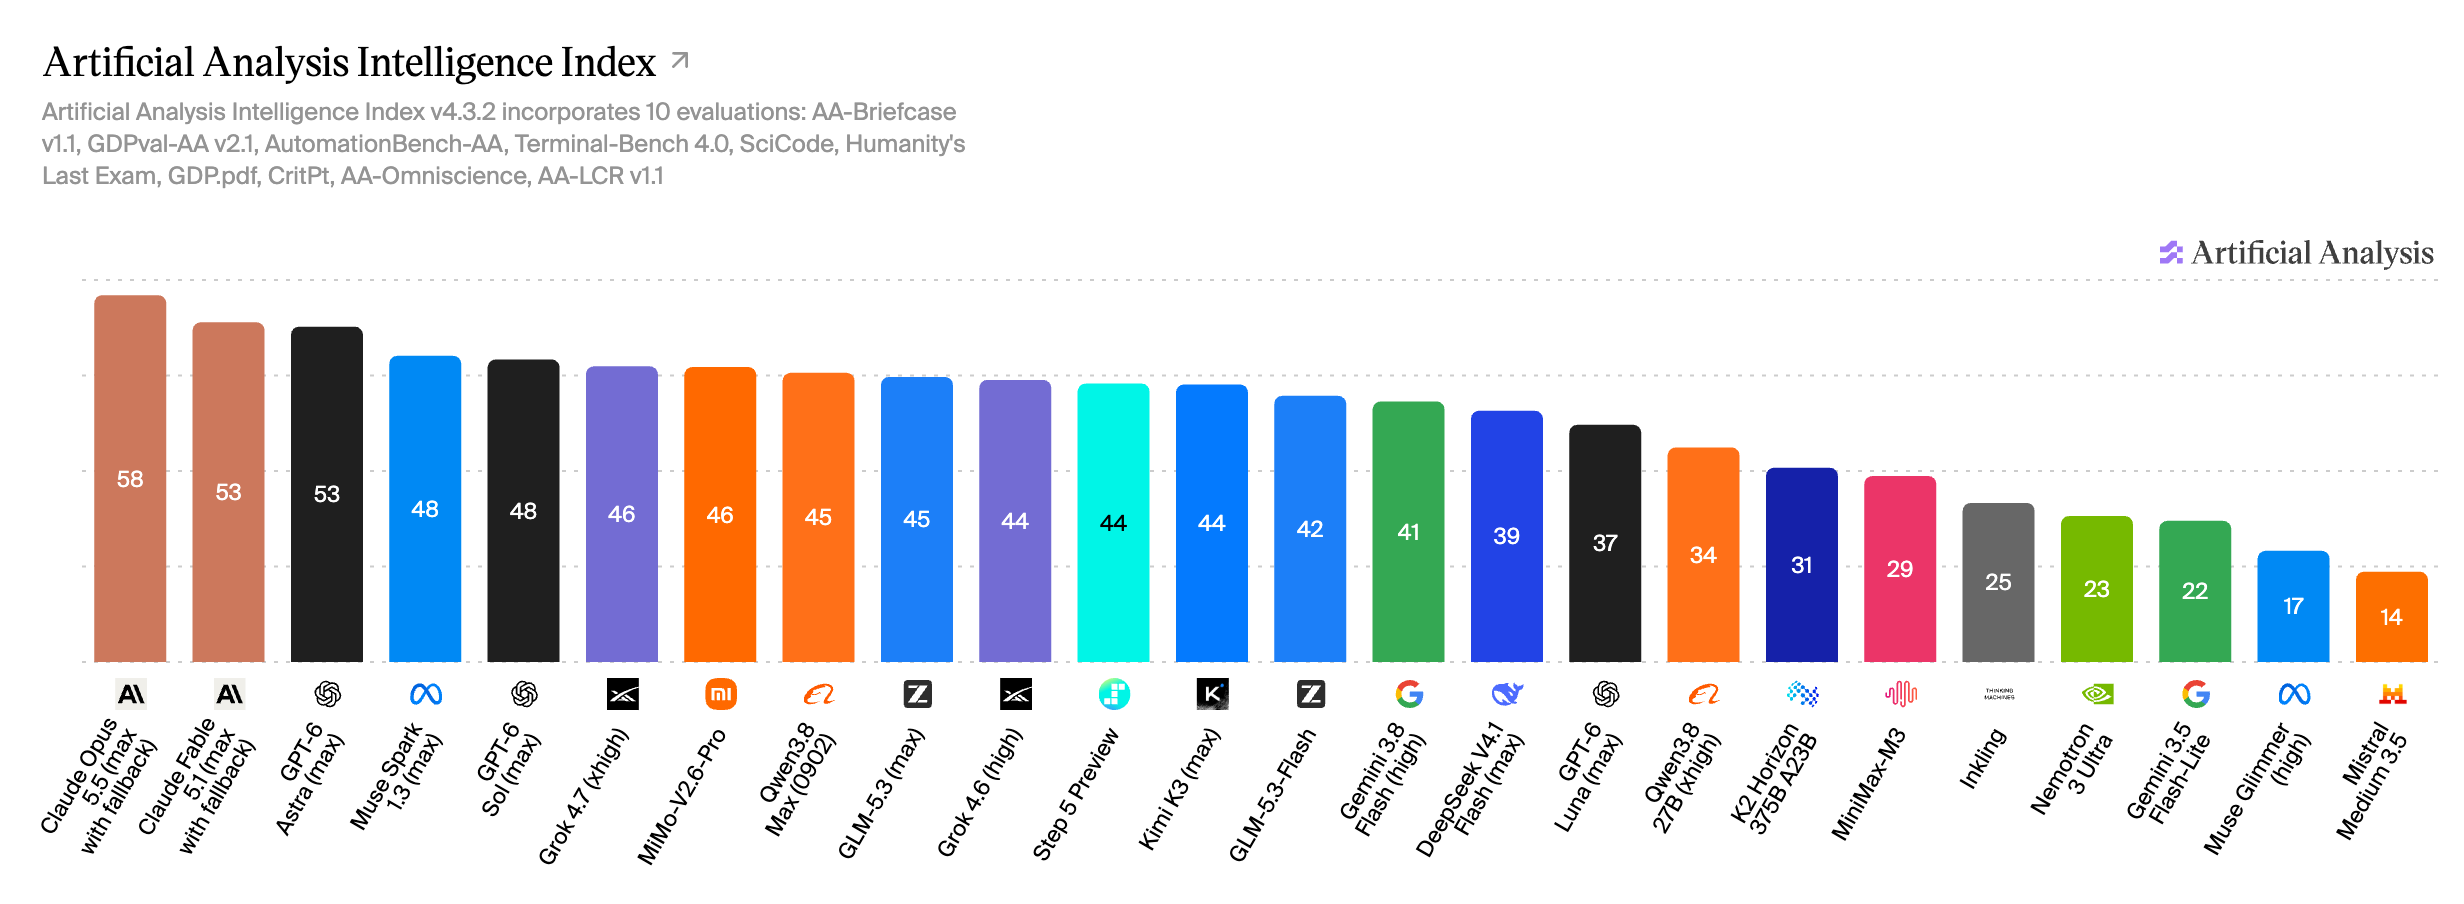
Общий интеллект
Сравните общие способности к рассуждению, программированию и интеллектуальной работе.
Интерпретация графика
В этой выборке Opus 5.5 лидирует с 58; Fable 5.1 и GPT-6 Astra округляются до 53. Учитывайте настройки рассуждения.
Специализированные оценки
Отдельно изучите программирование, рассуждение, фактические знания, длинный контекст и визуальное мышление.
Показать 19 графиков оценок19 оценок · разные шкалы
Интерпретация графика
Лидеры зависят от задачи: код — Terminal-Bench и SciCode, длинный контекст — AA-LCR, визуальное рассуждение — MMMU-Pro.
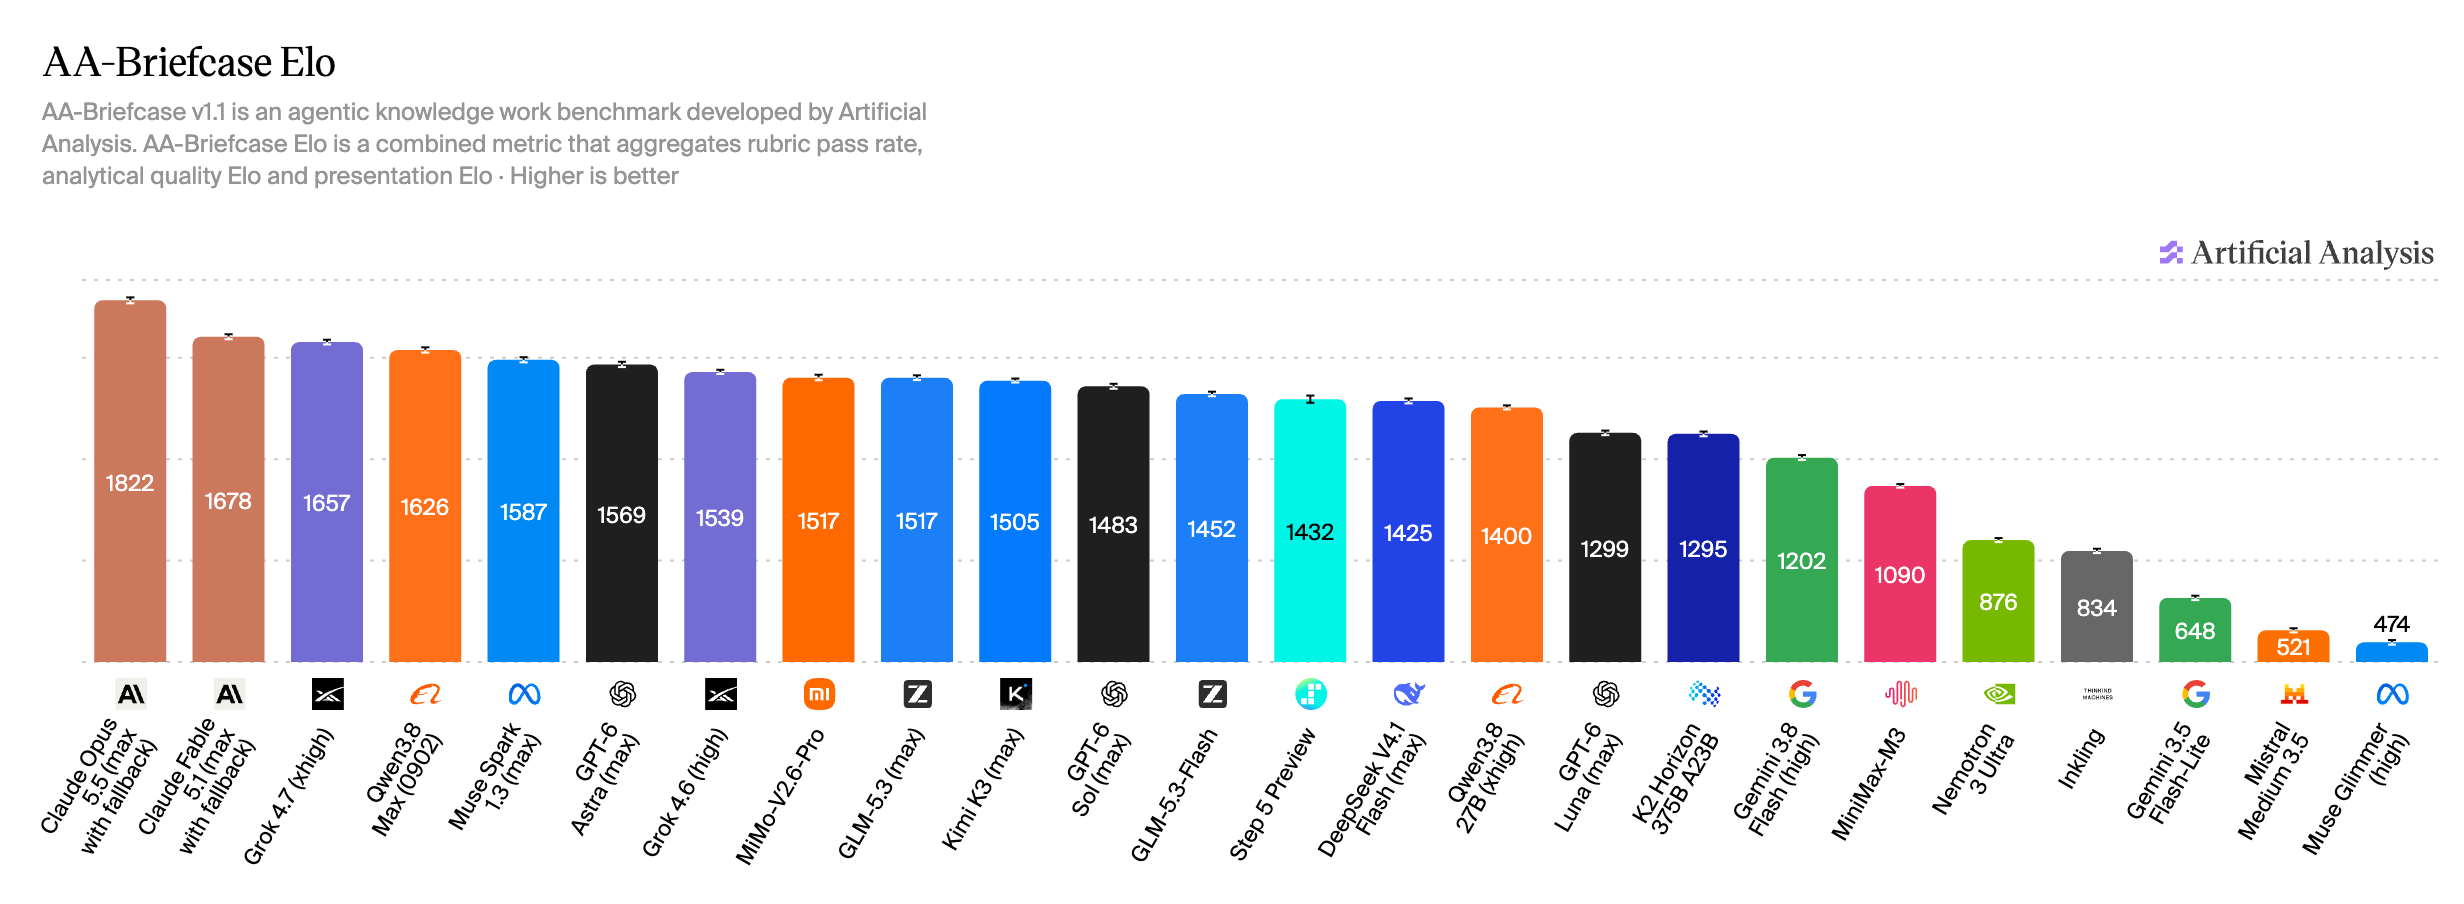
Агенты для интеллектуальной работы
Оцените способность агента превратить сложное задание в полезный результат.
Интерпретация графика
В этой выборке Opus 5.5 достигает 1822 Elo, Fable 5.1 — 1678, Grok 4.7 — 1657.
Интеллект и стоимость
Найдите нужные возможности при приемлемой стоимости задачи.

Интерпретация графика
Левая верхняя область сочетает высокие способности и низкую стоимость. Пунктирная граница помогает найти эффективные варианты в выборке.
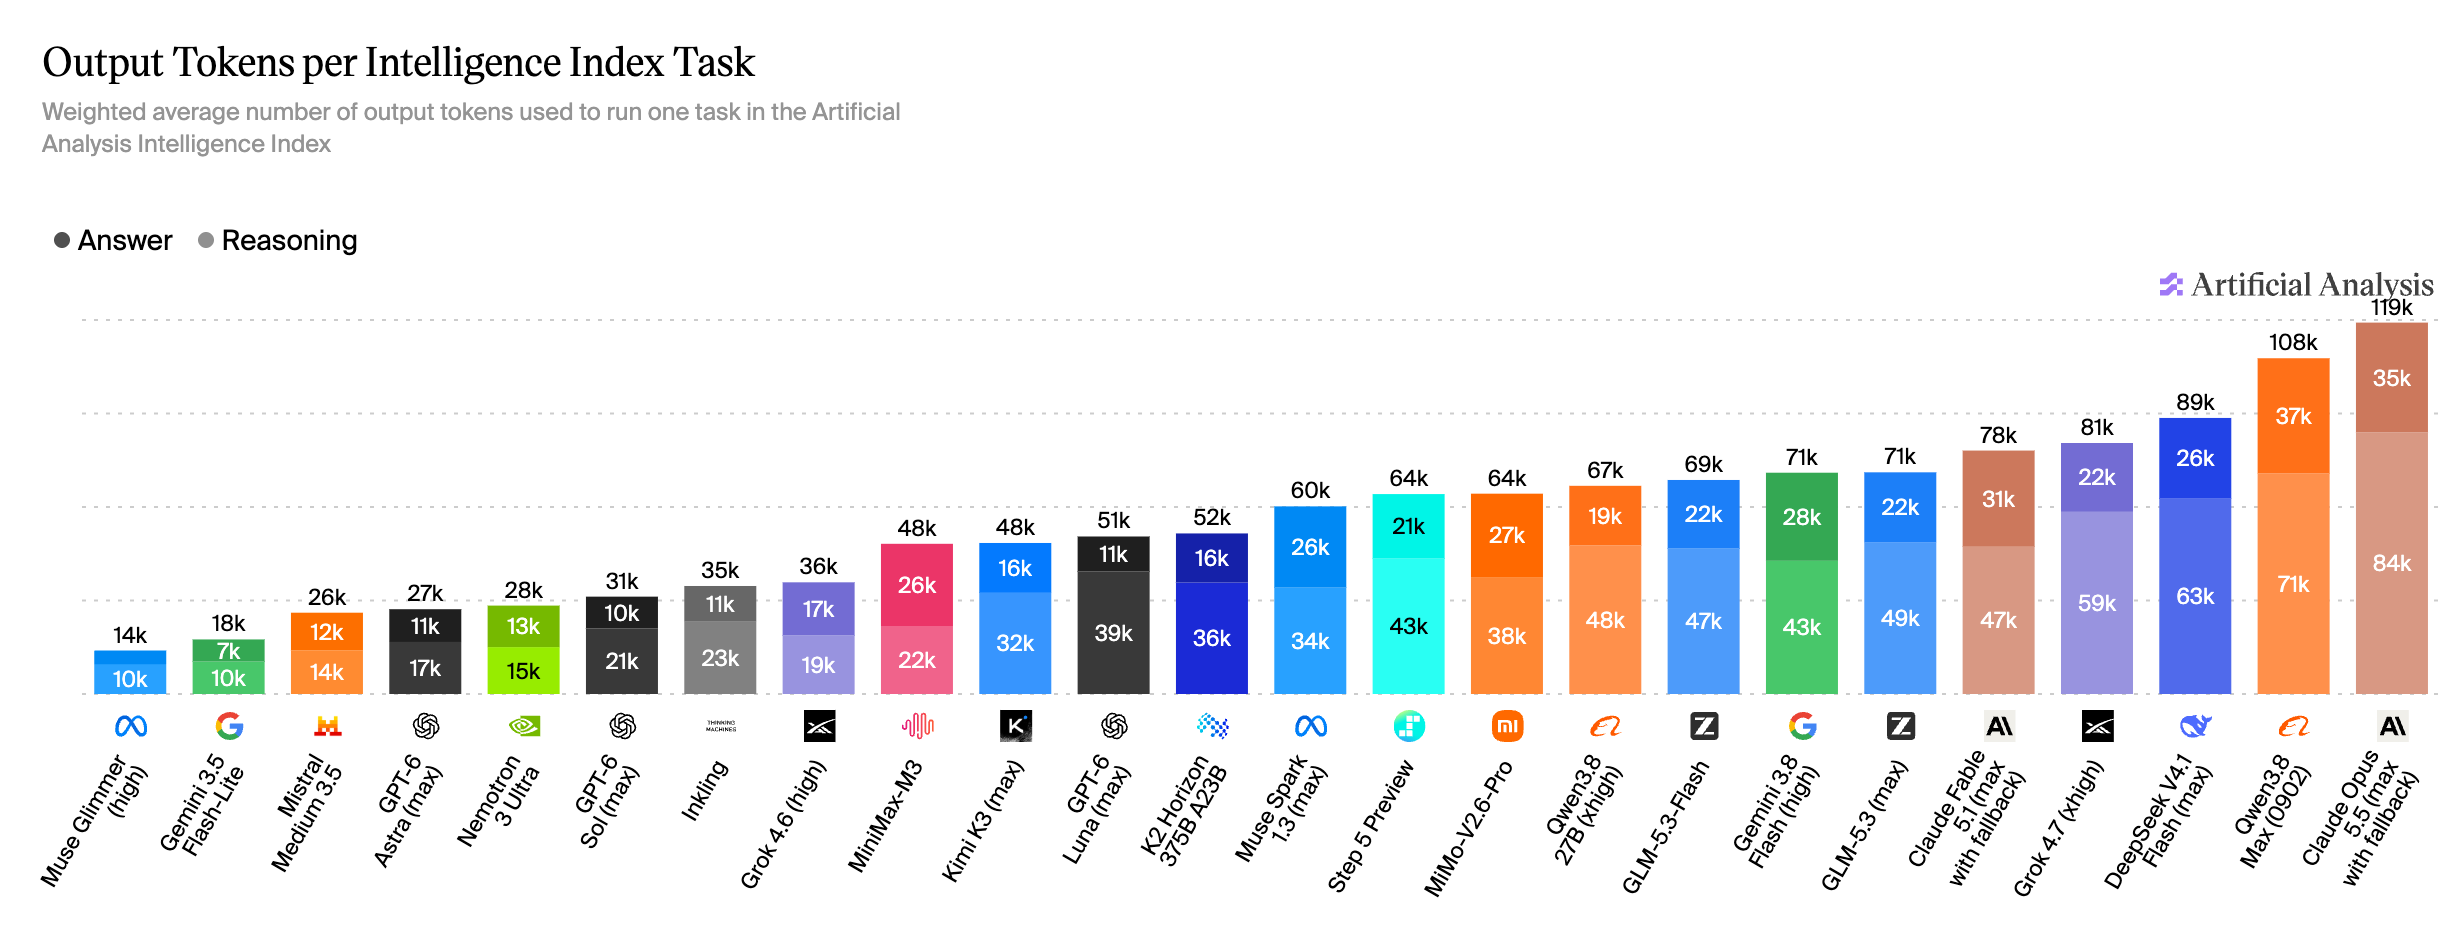
Эффективность токенов
Узнайте расход токенов рассуждения и ответа на одну тестовую задачу.
Интерпретация графика
Opus 5.5 расходует около 119k выходных токенов на задачу, GPT-6 Sol — 31k. Значительная доля приходится на рассуждение.
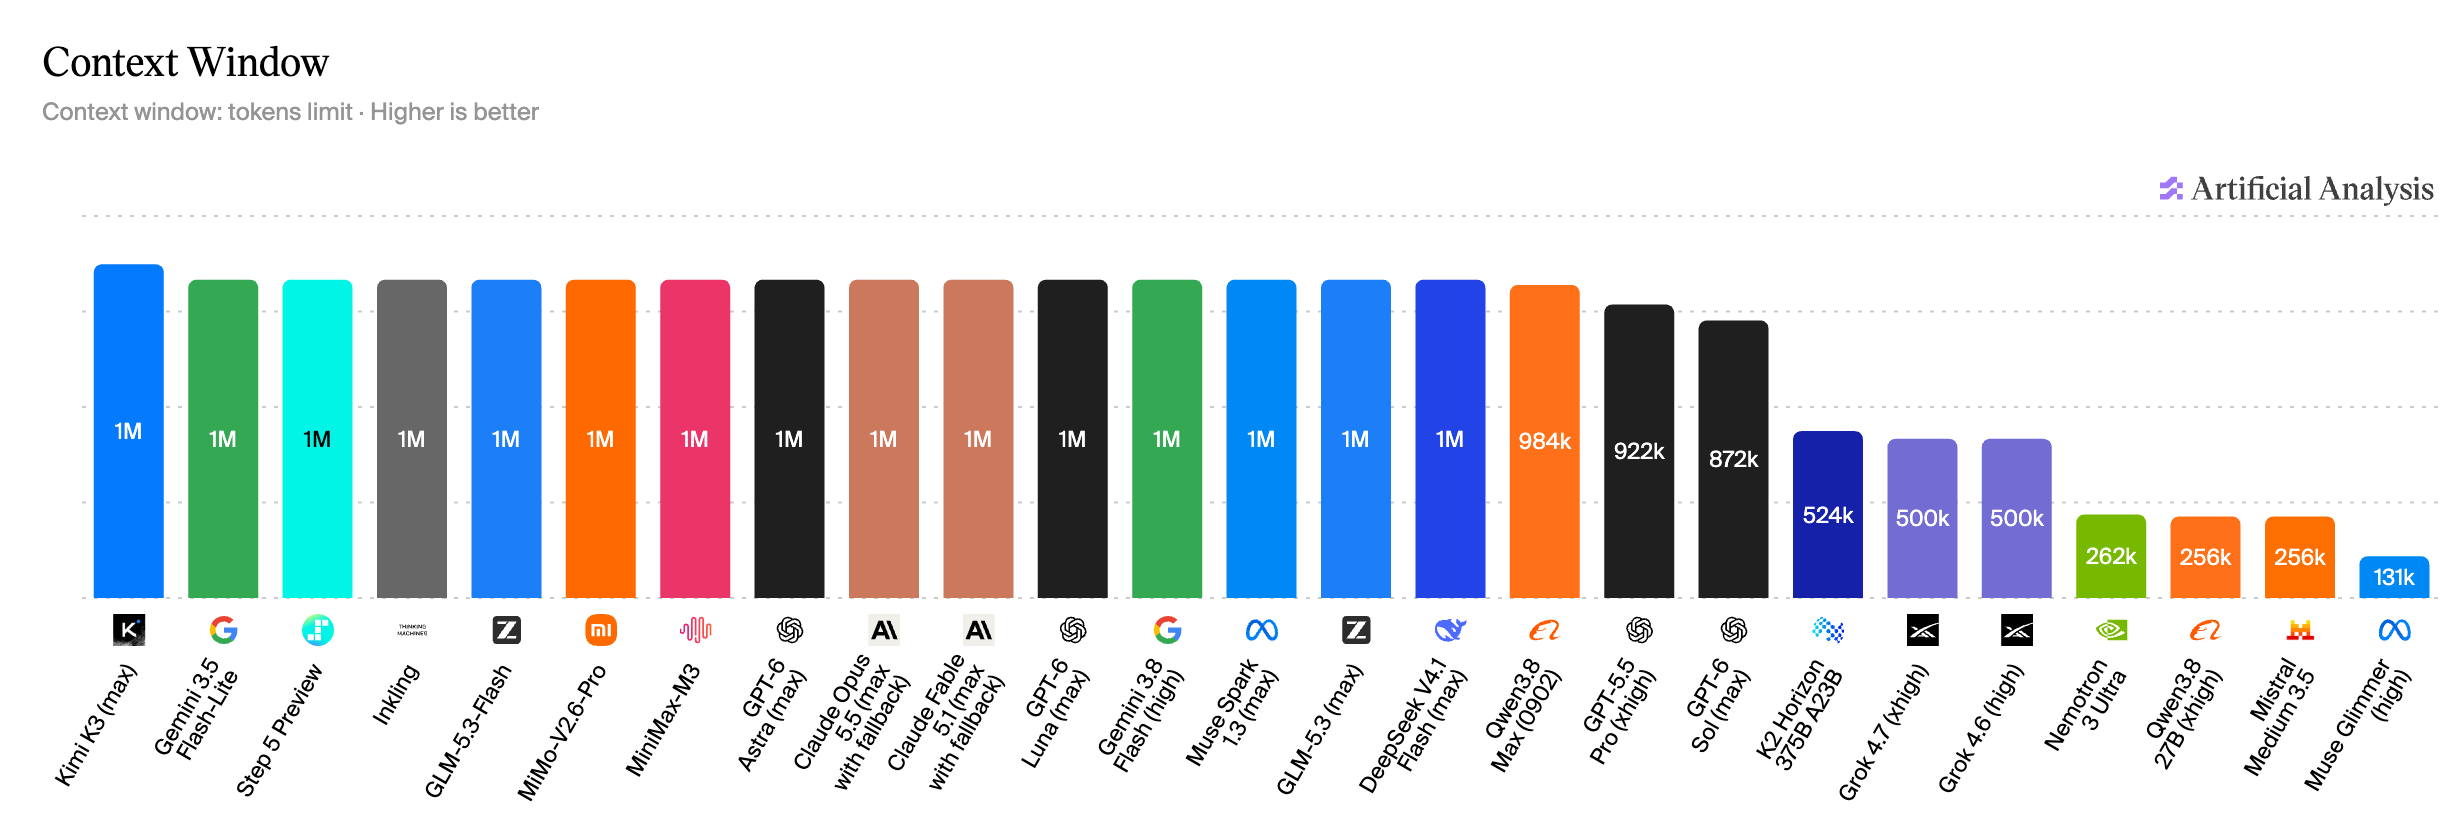
Объём контекста
Сравните доступный объём для документов, кода и истории диалога.
Интерпретация графика
Многие модели в выборке предлагают контекст около 1M токенов; Grok 4.7 — 500k, Mistral Medium 3.5 — 256k.
Скорость генерации
Сравните скорость поступления текста после начала генерации.
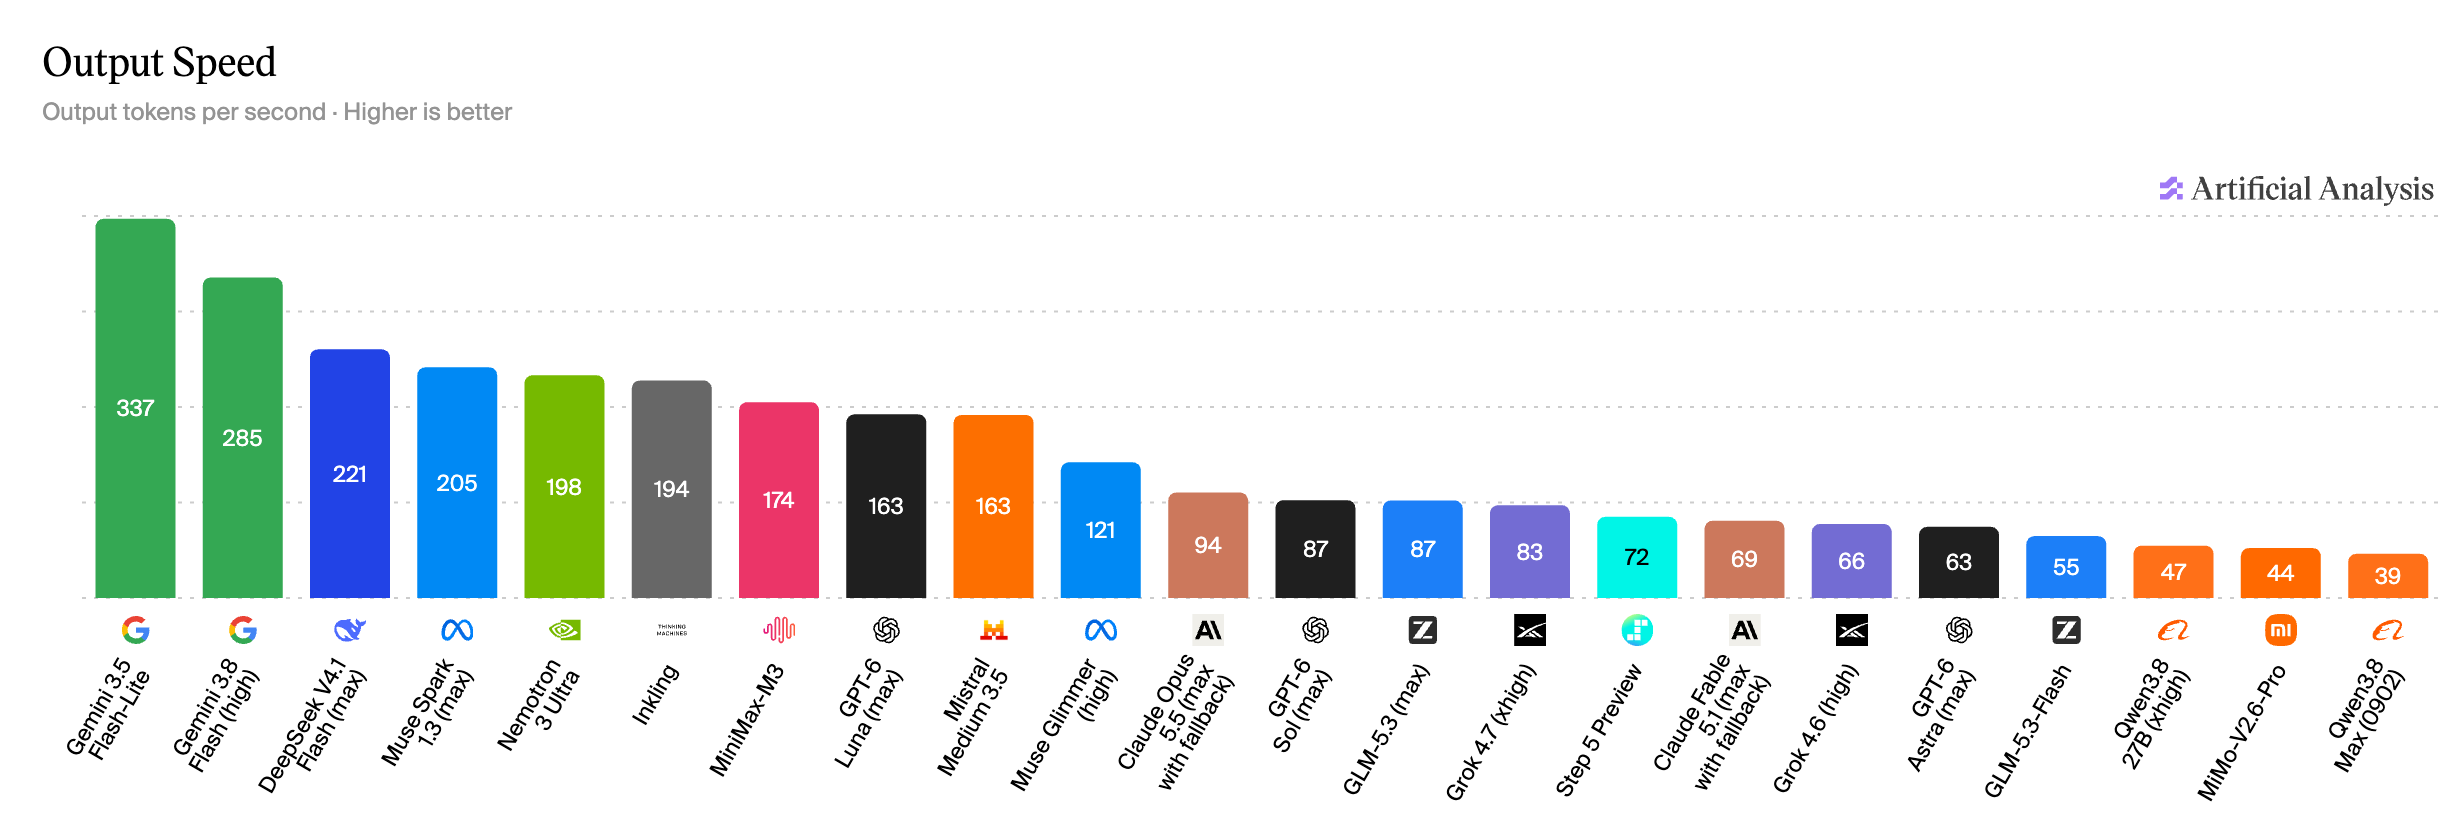
Интерпретация графика
В выборке Gemini 3.5 Flash-Lite достигает 337 токенов/с, Gemini 3.8 Flash при high — 285. Высокая скорость полезна для длинных ответов.
Время до начала ответа
Измерьте ожидание первого токена ответа для пользователя.
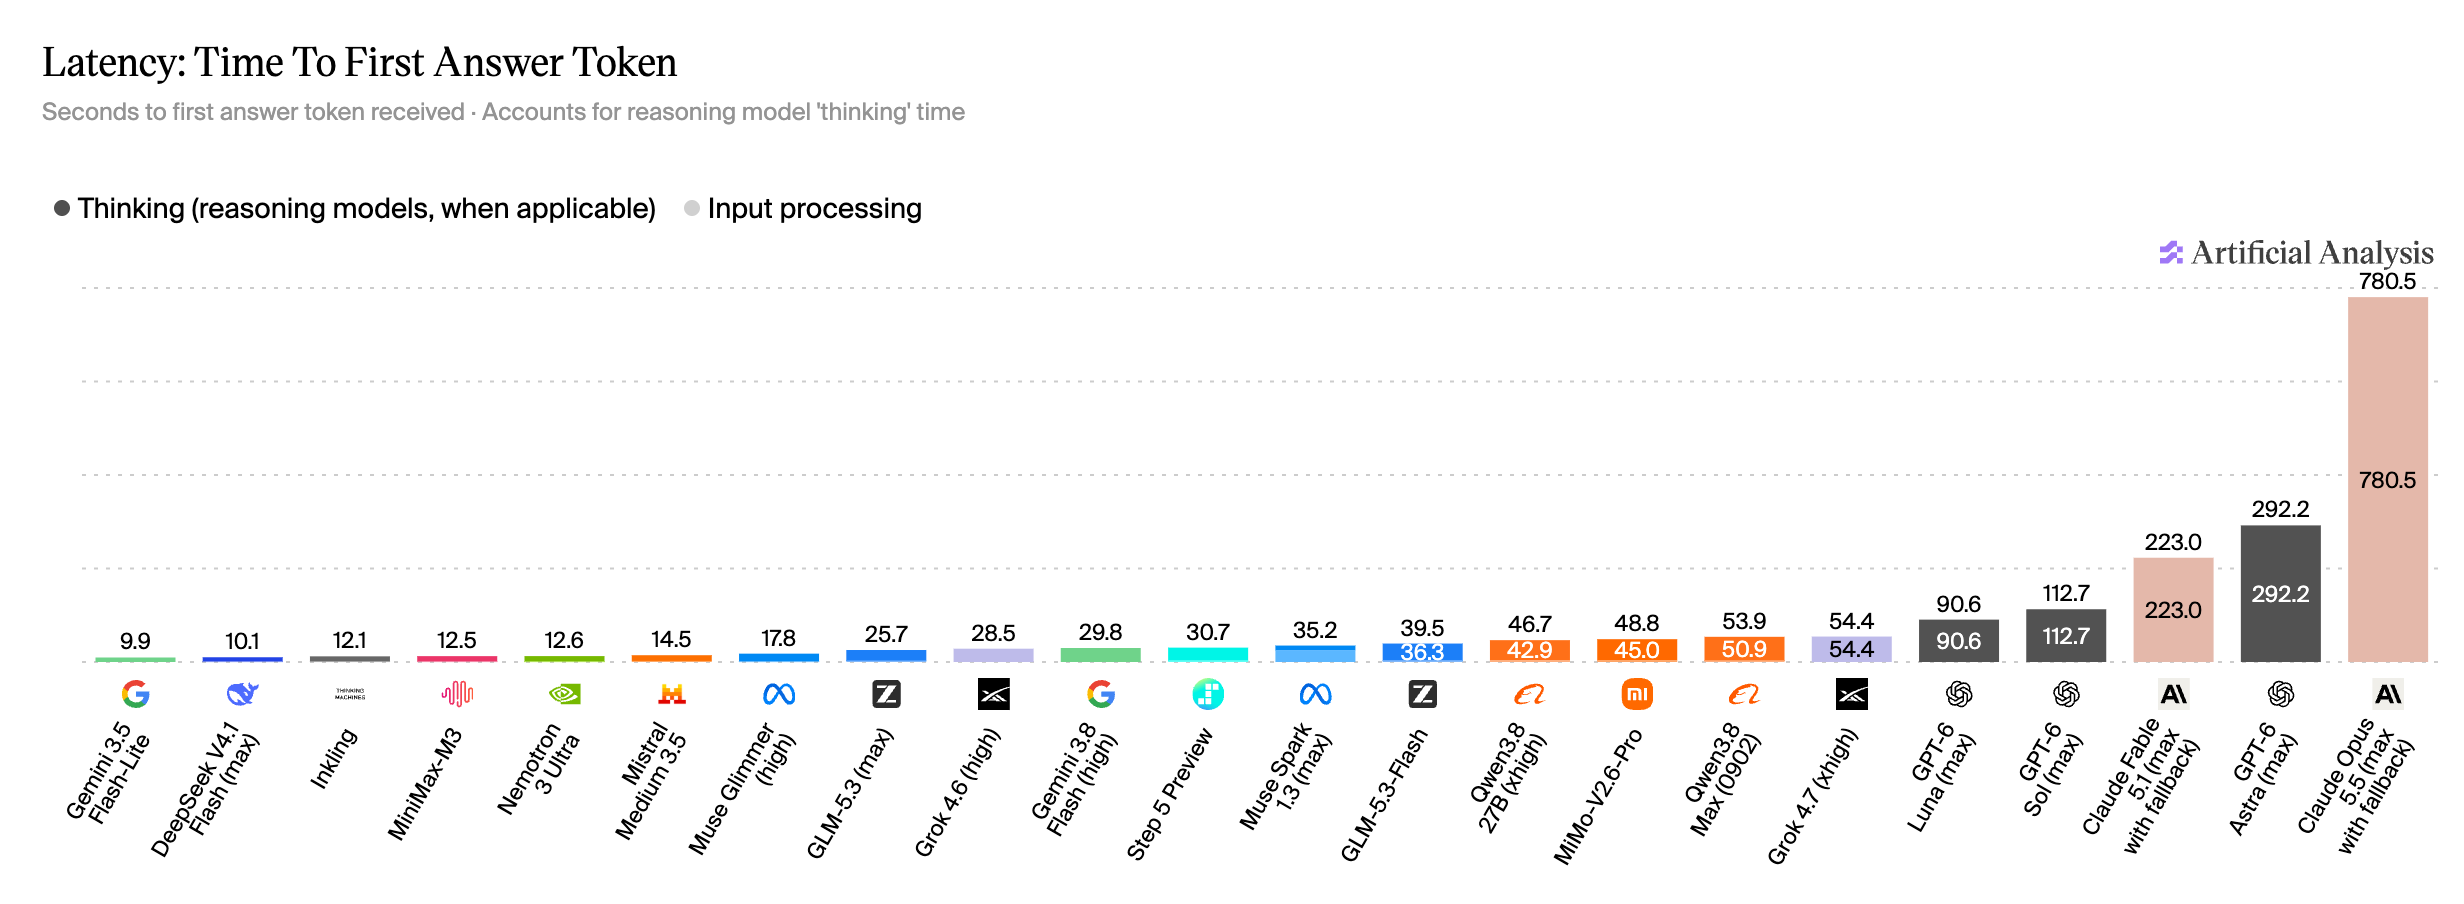
Интерпретация графика
Grok 4.7 при xhigh показывает 54,4 с, GPT-6 Astra при max — 292,2 с. Размышление может составлять основную часть ожидания.