
模型能力
從綜合智慧到實際使用成本與回應體驗,按八個維度了解模型能力。
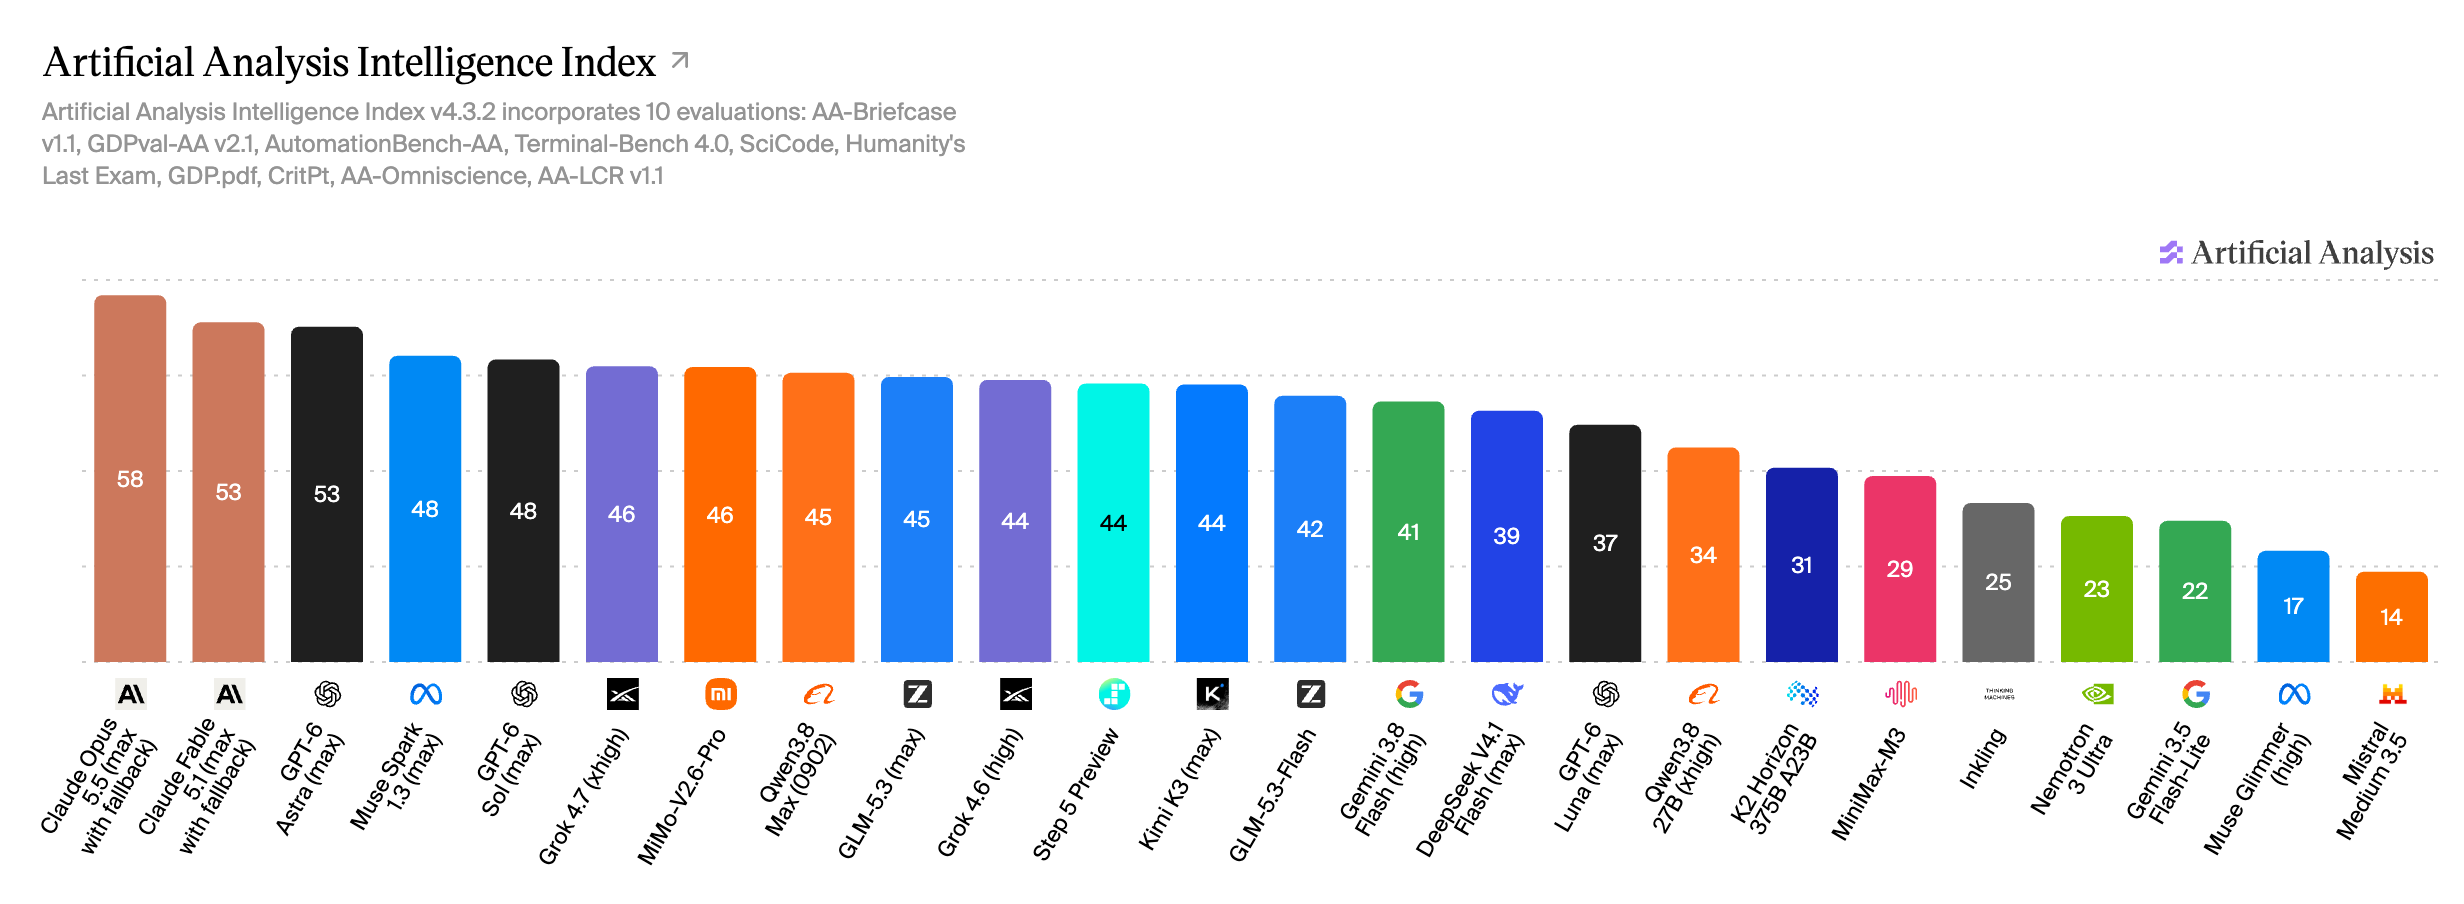
綜合智慧
綜合比較推理、程式設計與知識工作能力。
圖表解讀
本組模型中,Opus 5.5 以 58 分領先,Fable 5.1 與 GPT-6 Astra 均取整為 53 分。比較時應保留圖中推理檔位。
專項能力
分別查看程式設計、推理、事實知識、長上下文與視覺理解表現。
展開 19 項專項評測原圖19 項評測 · 獨立計分
圖表解讀
不同任務的領先模型會變化。程式設計可看 Terminal-Bench 與 SciCode,長上下文推理看 AA-LCR,視覺推理看 MMMU-Pro。
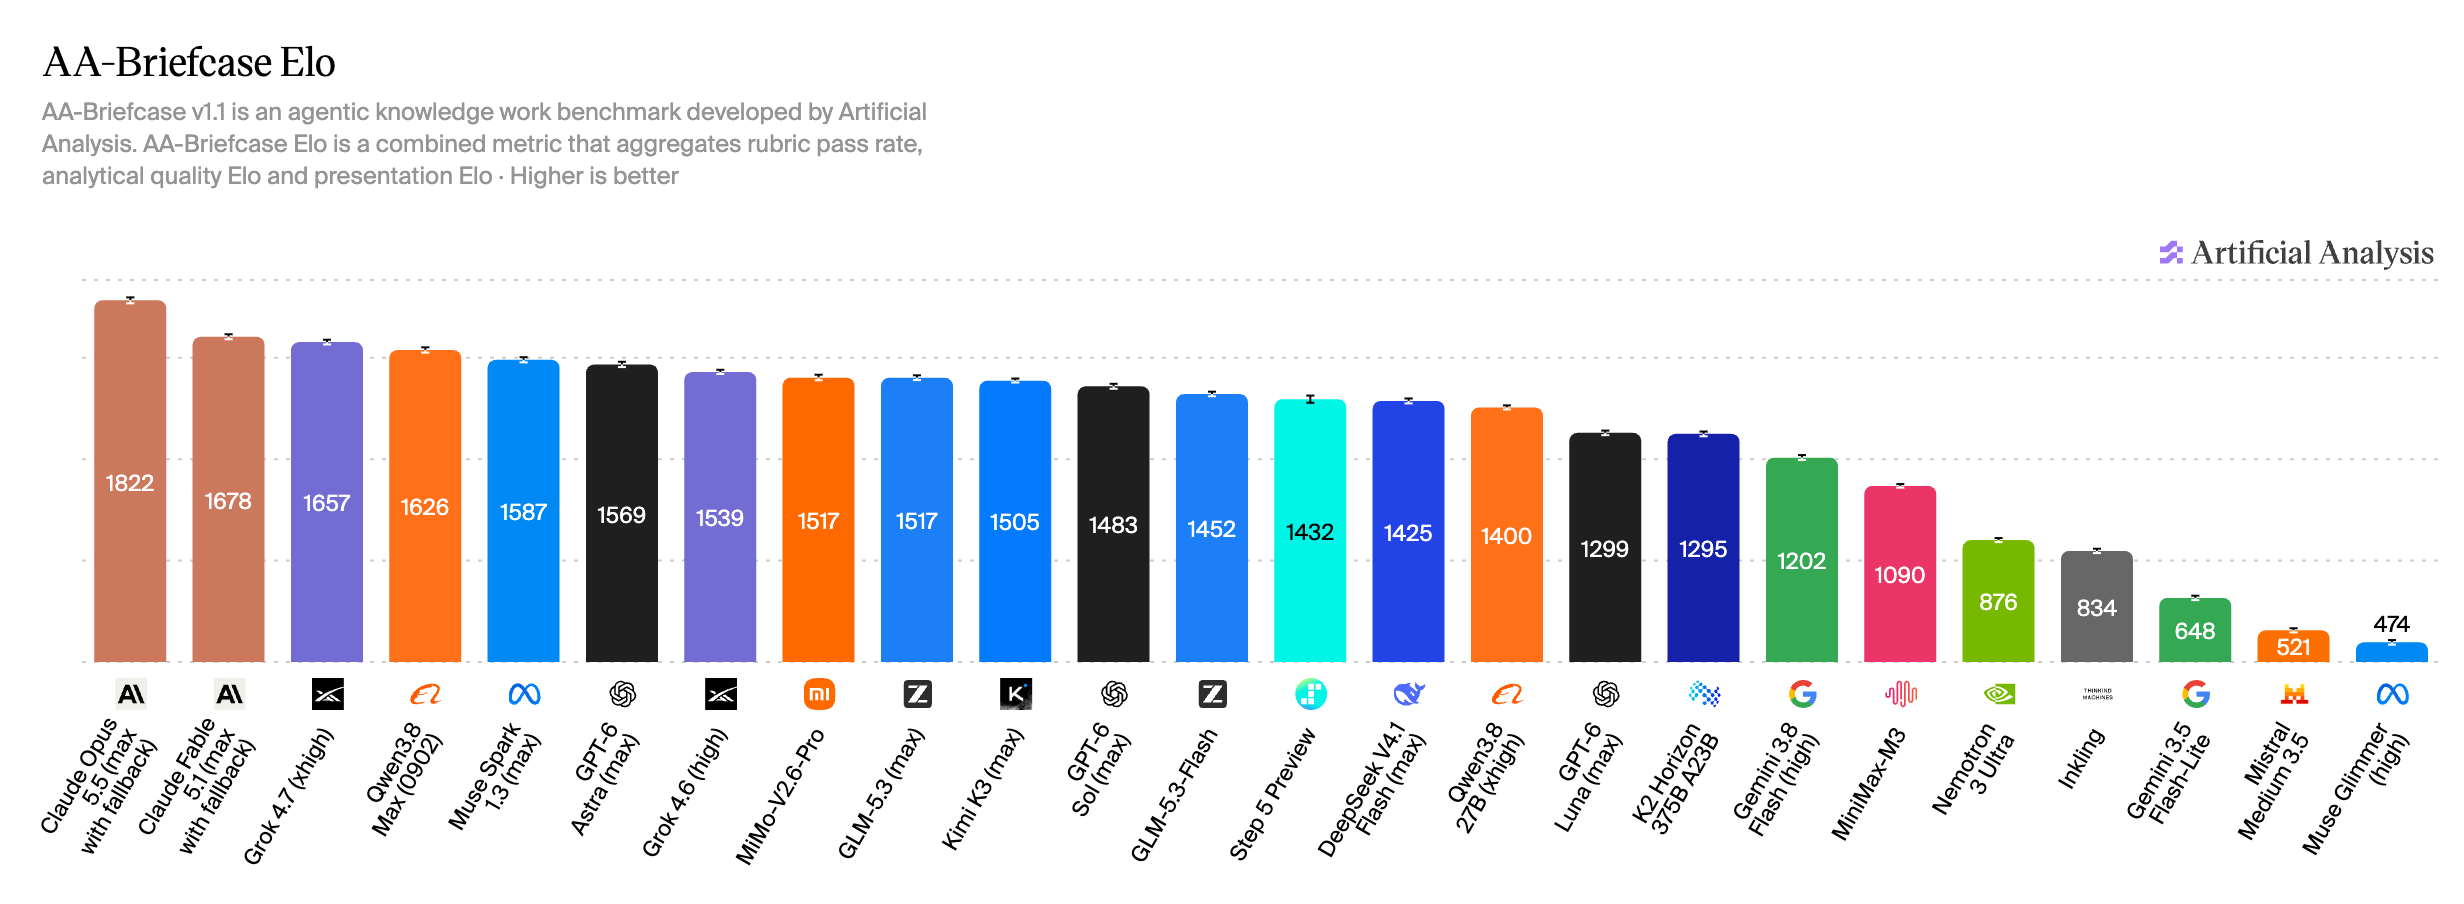
Agent 工作能力
評估 Agent 能否將複雜需求轉化為可用的工作成果。
圖表解讀
本組模型中,Opus 5.5 達到 1822 Elo,隨後是 Fable 5.1 的 1678 和 Grok 4.7 的 1657。
能力與成本
在所需能力與單任務成本之間找到合適平衡。

圖表解讀
越靠近左上方,能力越強、成本越低。虛線前沿幫助識別這組模型中兼顧能力與成本的選擇。
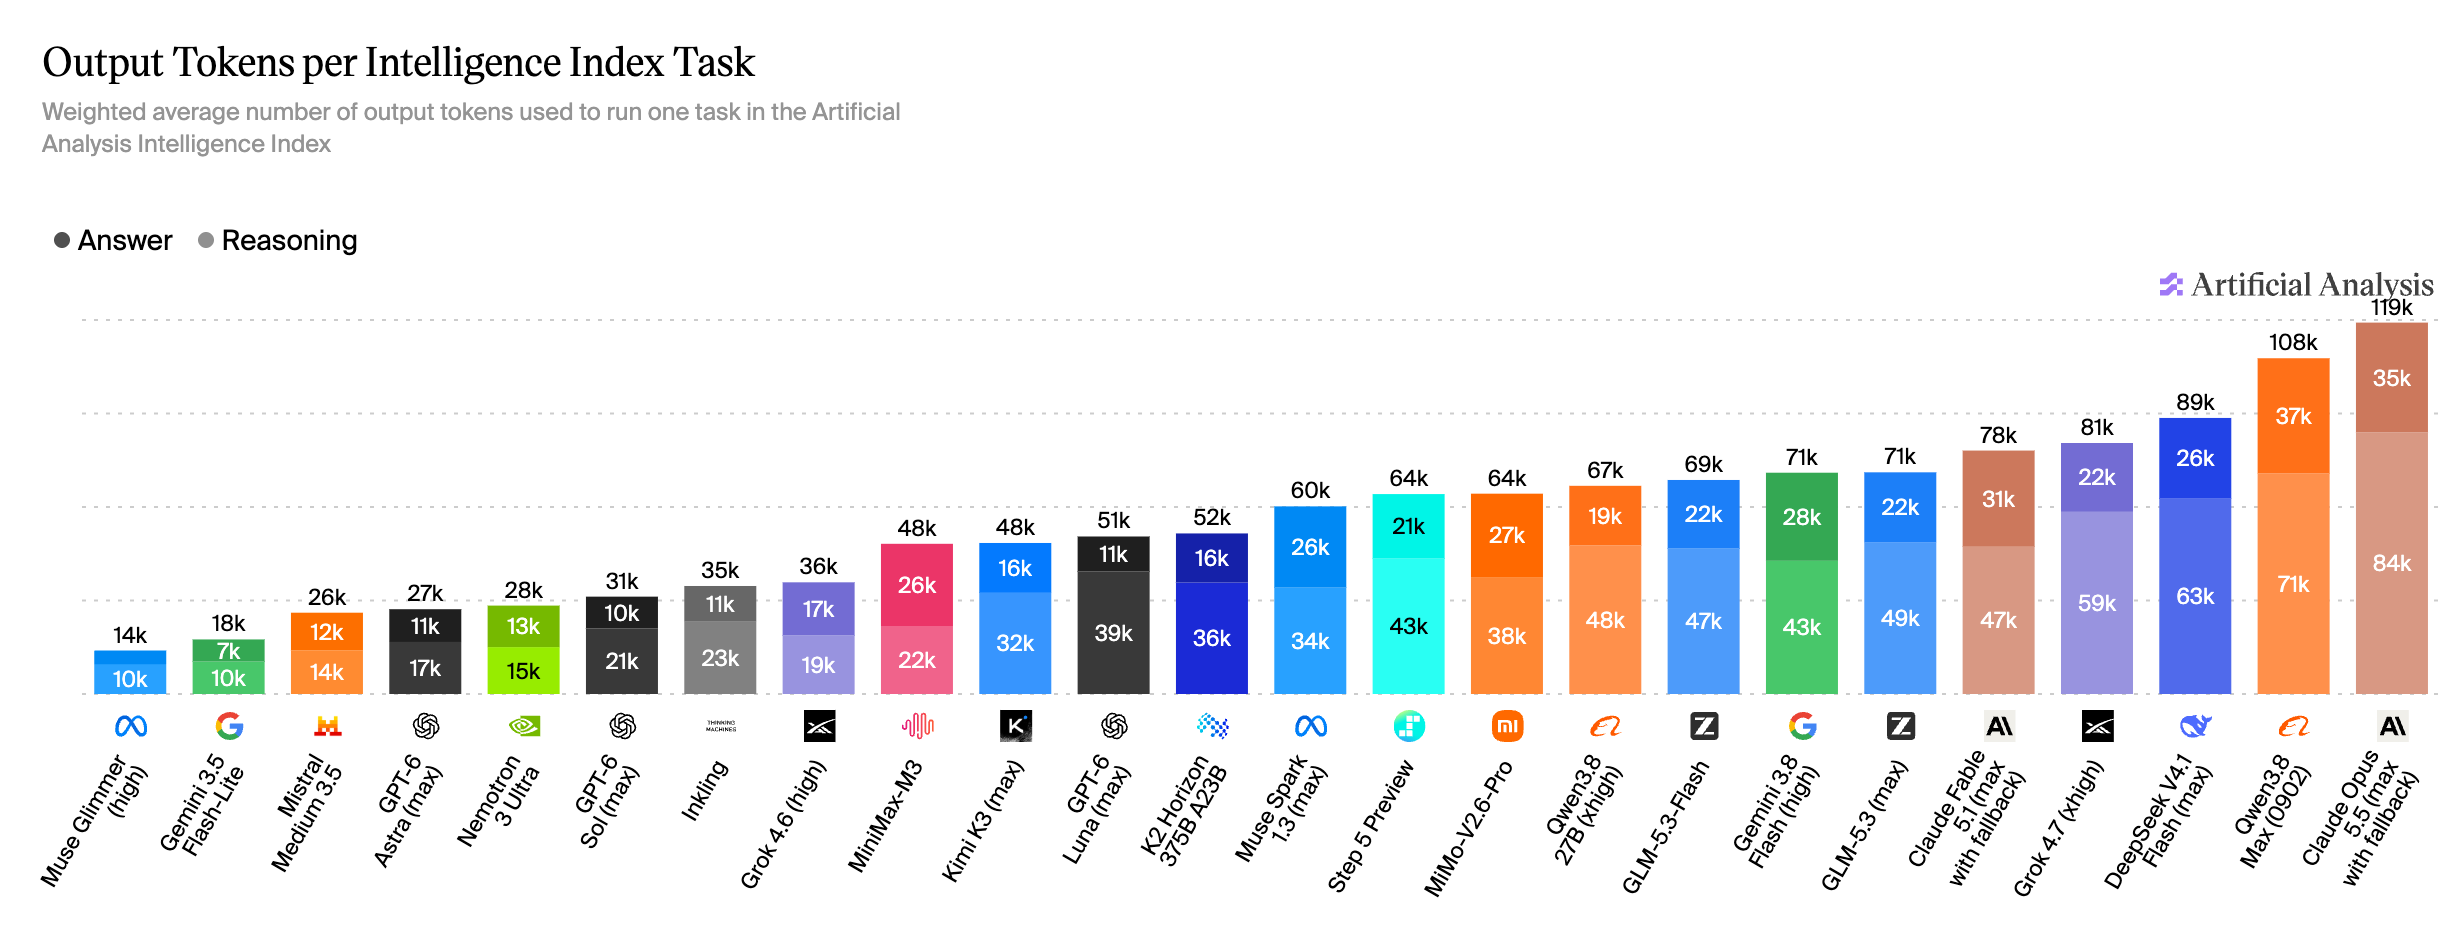
Token 效率
觀察完成一次評測任務需要多少推理和答案 Token。
圖表解讀
Opus 5.5 每任務約輸出 119k Token,GPT-6 Sol 約為 31k;推理 Token 占據了較大比例。
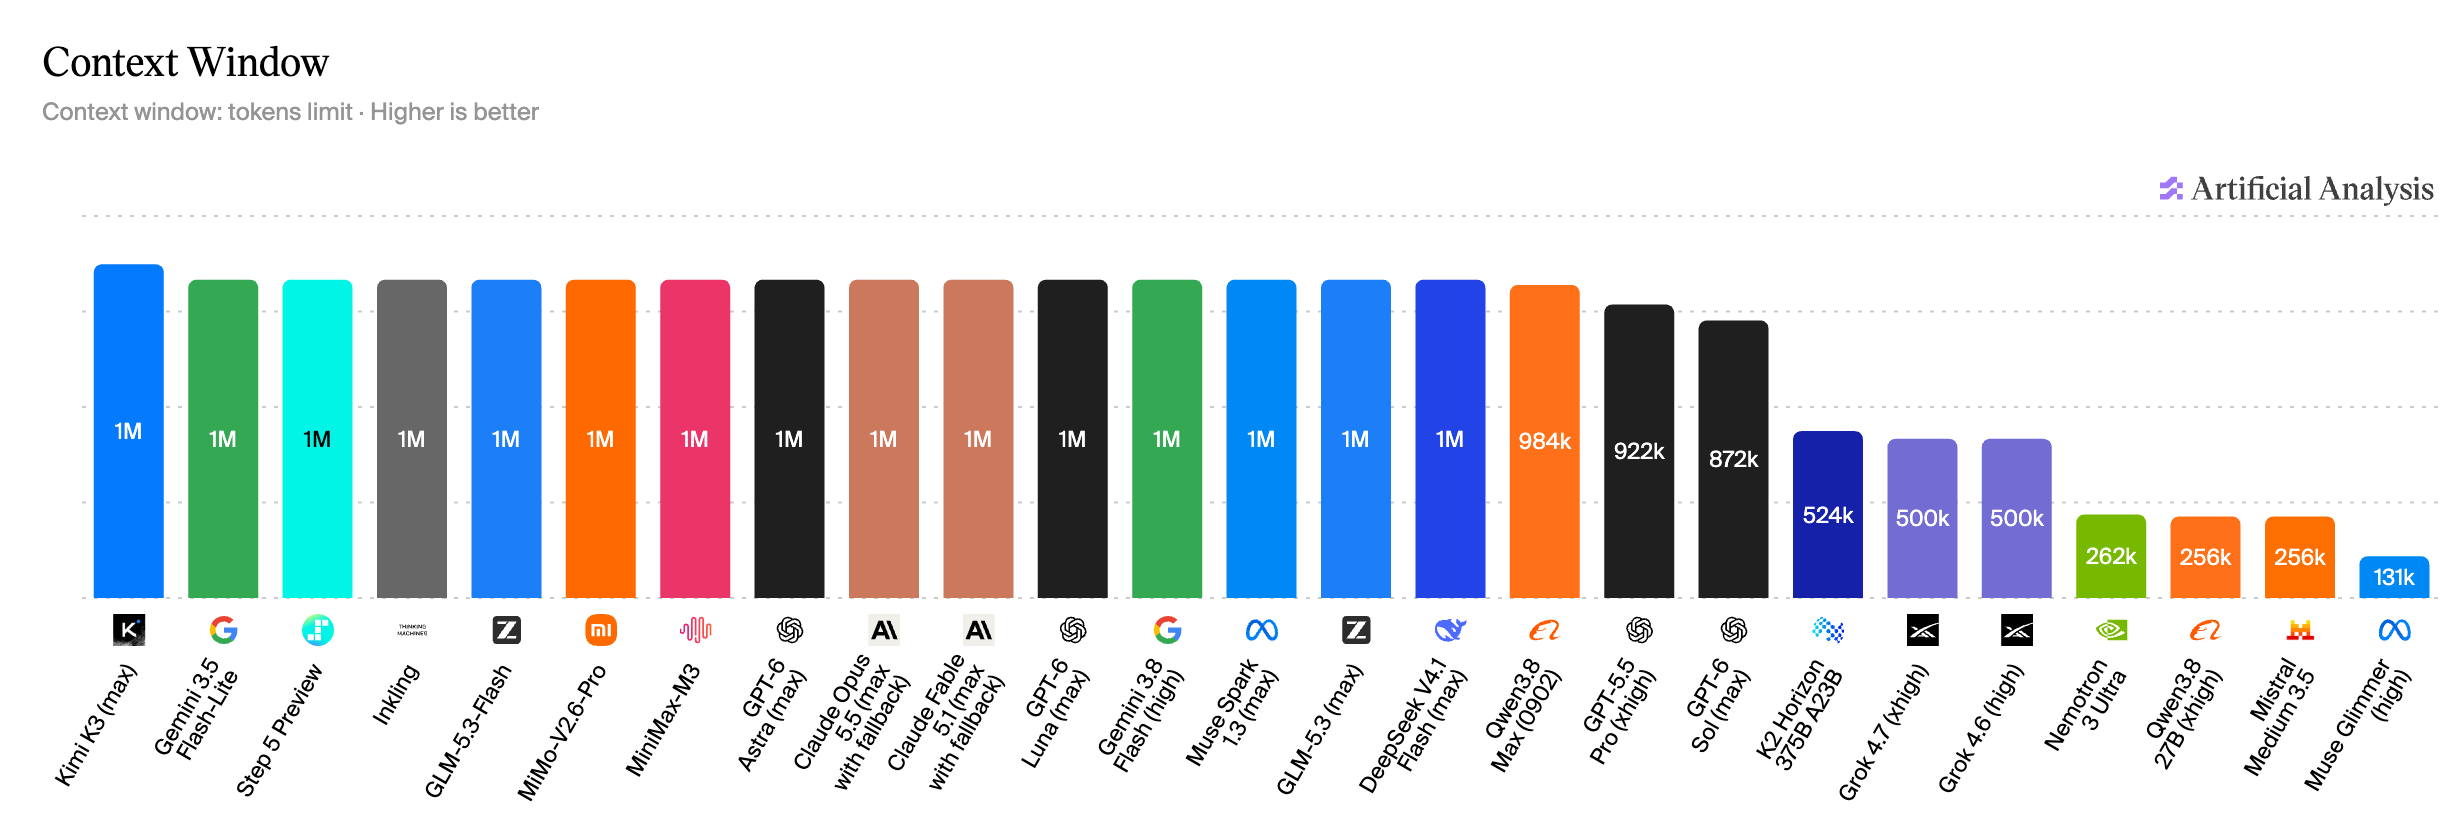
上下文容量
比較可容納文件、程式碼與歷史對話的上下文空間。
圖表解讀
本組許多模型的上下文約為 1M Token;圖中 Grok 4.7 為 500k,Mistral Medium 3.5 為 256k。
輸出速度
比較開始生成後,文字持續輸出的速度。
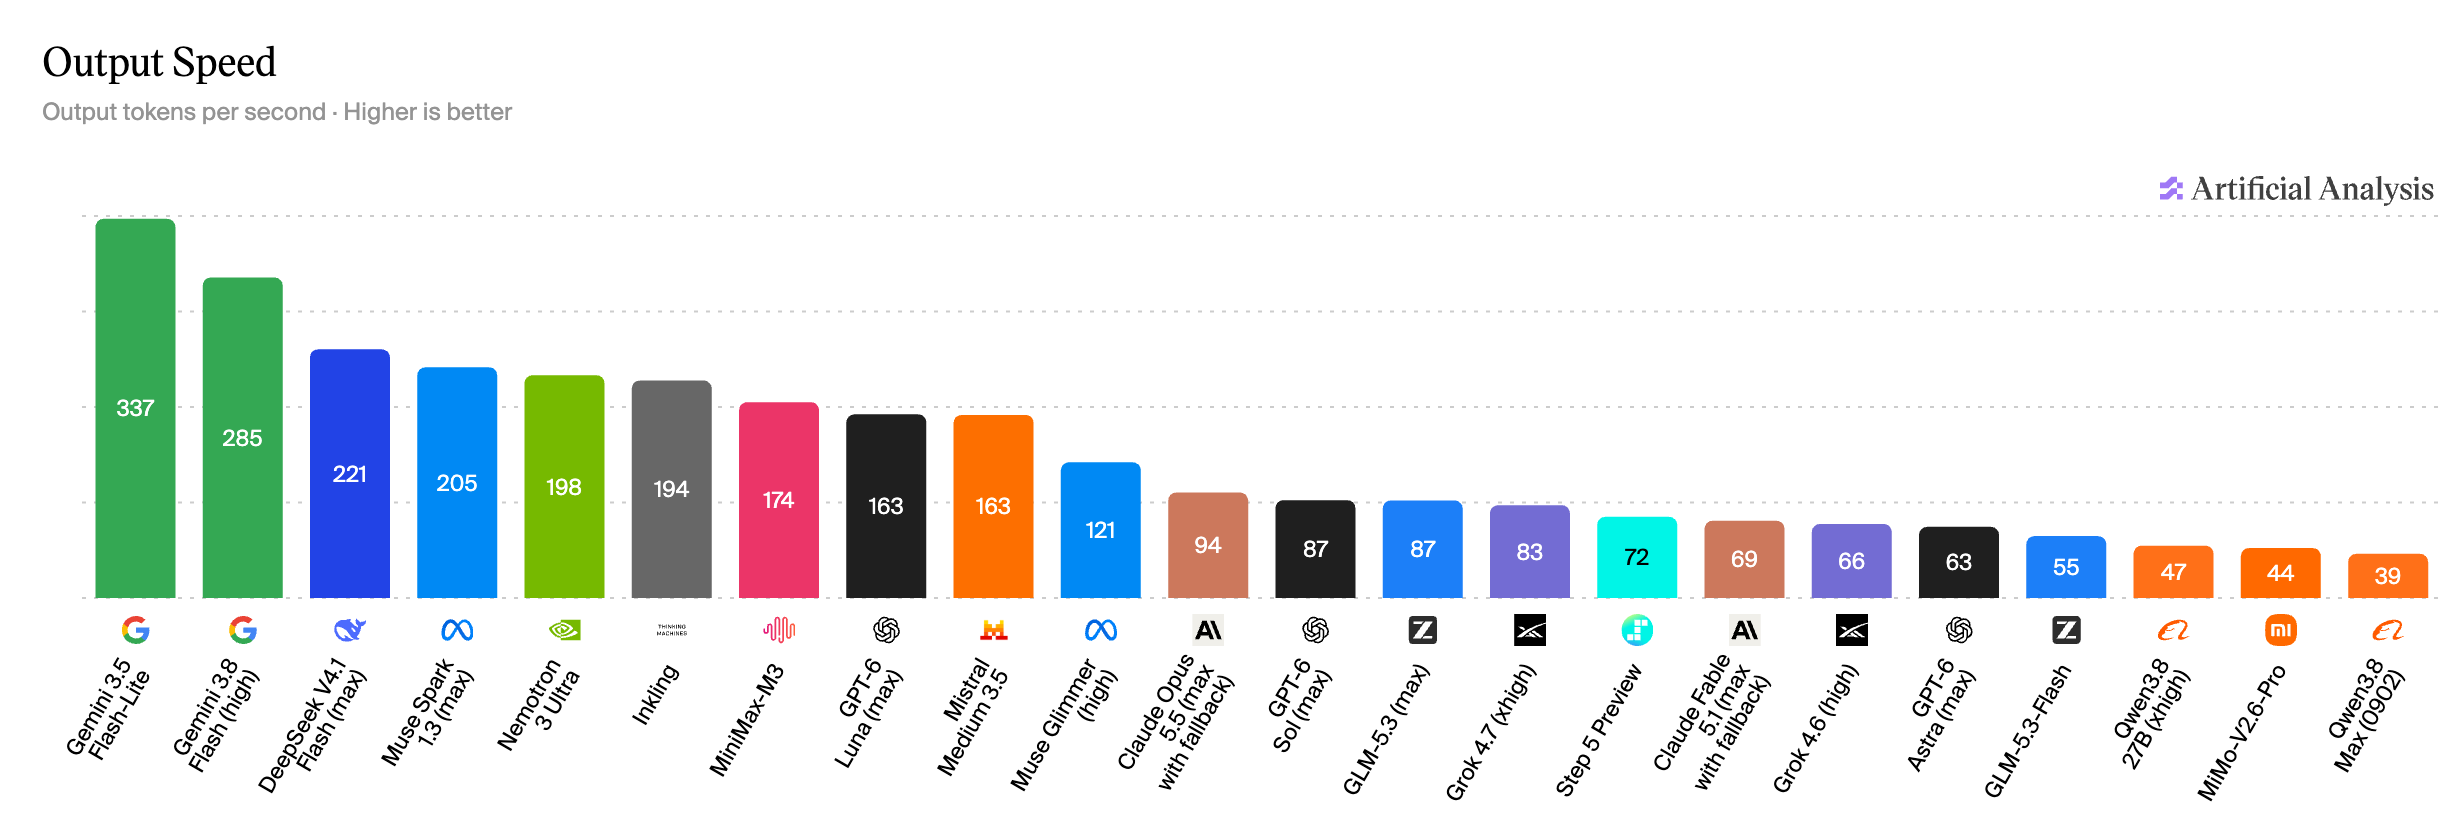
圖表解讀
本組 Gemini 3.5 Flash-Lite 達到 337 Token/秒,high 檔位的 Gemini 3.8 Flash 為 285 Token/秒。更高輸出速度有利於長答案的持續生成。
首答案延遲
了解使用者收到第一個答案 Token 前需要等待多久。
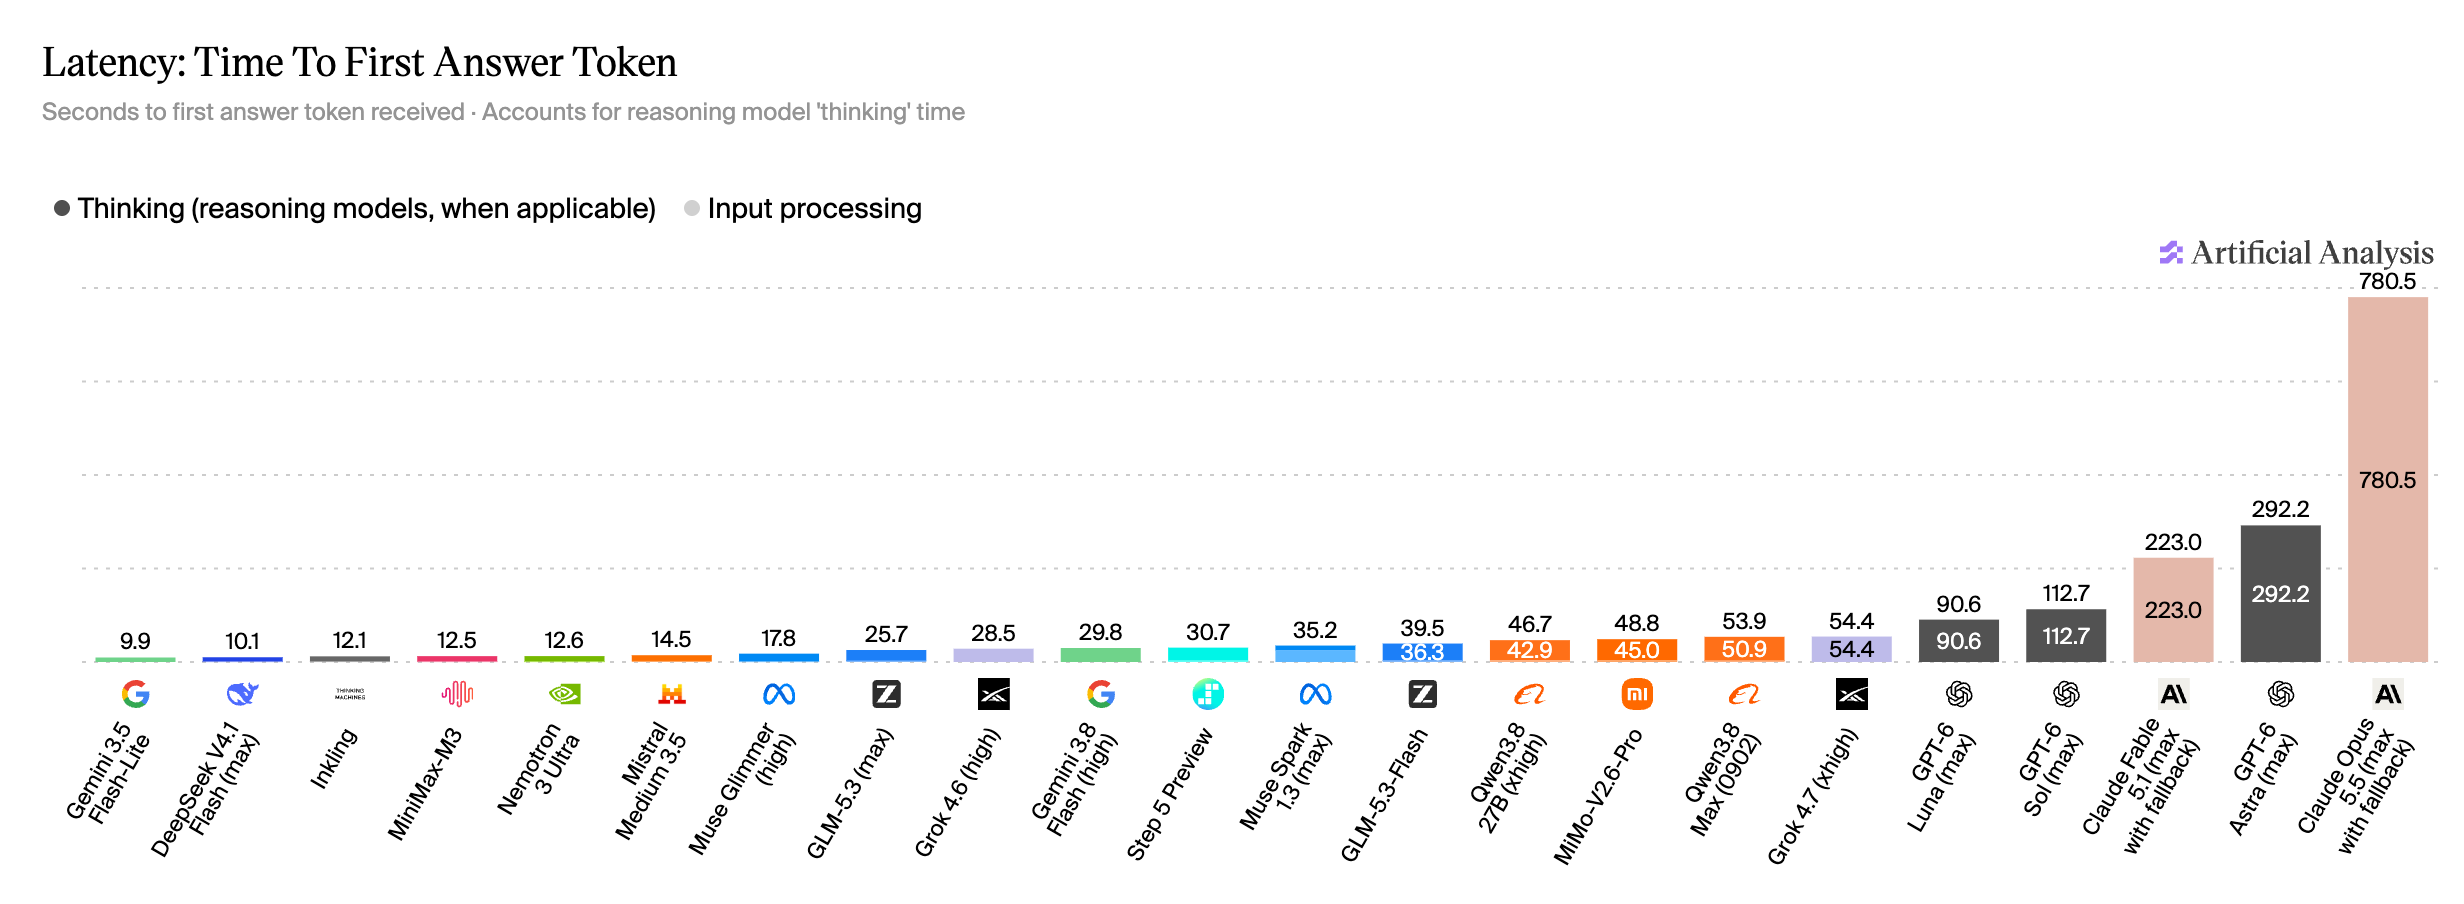
圖表解讀
圖中 xhigh 檔位的 Grok 4.7 為 54.4 秒,max 檔位的 GPT-6 Astra 為 292.2 秒。思考時間可能成為使用者等待的主要部分。